I limiti del monitoraggio nativo della virtualizzazione
Il monitoraggio della virtualizzazione non si limita a verificare se le macchine virtuali sono in esecuzione. Richiede la comprensione di come macchine virtuali, hypervisor, host, storage, reti, sistemi operativi guest e servizi interagiscono all'interno dell'infrastruttura.
Gli strumenti nativi integrati nelle piattaforme di virtualizzazione sono essenziali per la gestione delle macchine virtuali e dei relativi ambienti. Tuttavia, la visibilità è solitamente limitata a quella specifica piattaforma. Questo diventa un importante punto di attrito operativo quando le organizzazioni distribuiscono piattaforme secondarie per ottimizzare i costi o isolare specifici carichi di lavoro. L'utilizzo di più piattaforme comporta l'affidamento a molteplici strumenti nativi che non comunicano tra loro. Un monitoraggio affidabile delle prestazioni per gli ambienti virtualizzati richiede un livello superiore che colleghi i dati della piattaforma con i dati del sistema operativo guest, le metriche dell'infrastruttura, i dati storici e gli avvisi operativi.
TL;DR:
- Un monitoraggio efficace richiede un approccio unificato che correli le metriche della piattaforma, i dati del sistema operativo guest, lo storage e le prestazioni della rete.
- Gli strumenti nativi delle piattaforme come VMware o Proxmox sono essenziali per la gestione, ma manca loro la visibilità cross-platform e una conoscenza approfondita a livello guest.
- Una visione completa e unificata riduce i silos di strumenti, consente una pianificazione predittiva della capacità e migliora significativamente la risoluzione dei problemi operativi nell’intera infrastruttura virtualizzata.
La virtualizzazione rende l’infrastruttura più flessibile ma aggiunge anche astrazione
Le macchine virtuali possono essere create rapidamente, migrate dal vivo, ridimensionate, consolidate, sottoposte a backup, clonate e rimosse. Allo stesso tempo, le macchine virtuali dipendono da CPU, memoria, storage, percorsi di rete, hypervisor, cluster e hardware fisico condivisi.
Questa flessibilità rende l'infrastruttura virtuale più difficile da monitorare. Una macchina virtuale può apparire integra nella dashboard di una piattaforma nativa mentre gli utenti segnalano comunque problemi di prestazioni. Il problema può risiedere all'interno del sistema operativo guest, sull'host, nello strato di storage, nella comunicazione tra VM sullo stesso host fisico o in un punto qualsiasi del percorso di rete all'esterno dell'hypervisor.
Gli strumenti nativi non sono attrezzati per fornire un'unica visione operativa nell'intero data center. Ecco perché il monitoraggio della virtualizzazione deve collegare lo strato virtuale con l'infrastruttura fisica sottostante, dagli hypervisor e host allo storage, alle reti e ai sistemi operativi guest.
Cosa deve coprire un monitoraggio efficace della virtualizzazione
Ottenere una migliore visibilità negli ambienti virtualizzati non richiede la sostituzione degli strumenti esistenti. Richiede la raccolta dei dati corretti, la corretta mappatura delle relazioni e la trasformazione delle metriche di prestazione in avvisi, grafici e tendenze.
Raccolta dei dati da più livelli
Un monitoraggio efficace della virtualizzazione richiede visibilità sui livelli che influenzano lo stato di salute e le prestazioni delle macchine virtuali, tra cui:
- Hypervisor e server host – CPU ready time, utilizzo della memoria, memory ballooning, swap dell'host, overcommitment, stato di salute dei nodi e del cluster.
- Macchine virtuali e sistemi operativi guest – CPU, RAM, partizioni, file system, processi, servizi, swap del guest, log e dati di rete a livello di sistema operativo.
- Storage – Utilizzo, latenza dei datastore, IOPS del disco, throughput di lettura/scrittura, snapshot, replicazione e utilizzo della capacità.
- Rete – Throughput, perdita di pacchetti, latenza, ritrasmissioni, comportamento degli switch virtuali, saturazione della NIC e traffico Est-Ovest tra VM sullo stesso host fisico.
Questo mostra perché il monitoraggio delle VM non può fermarsi alla sola macchina virtuale. I team hanno anche bisogno di visibilità su host, storage, reti e livelli di piattaforma che influenzano lo stato di salute e le prestazioni delle VM.
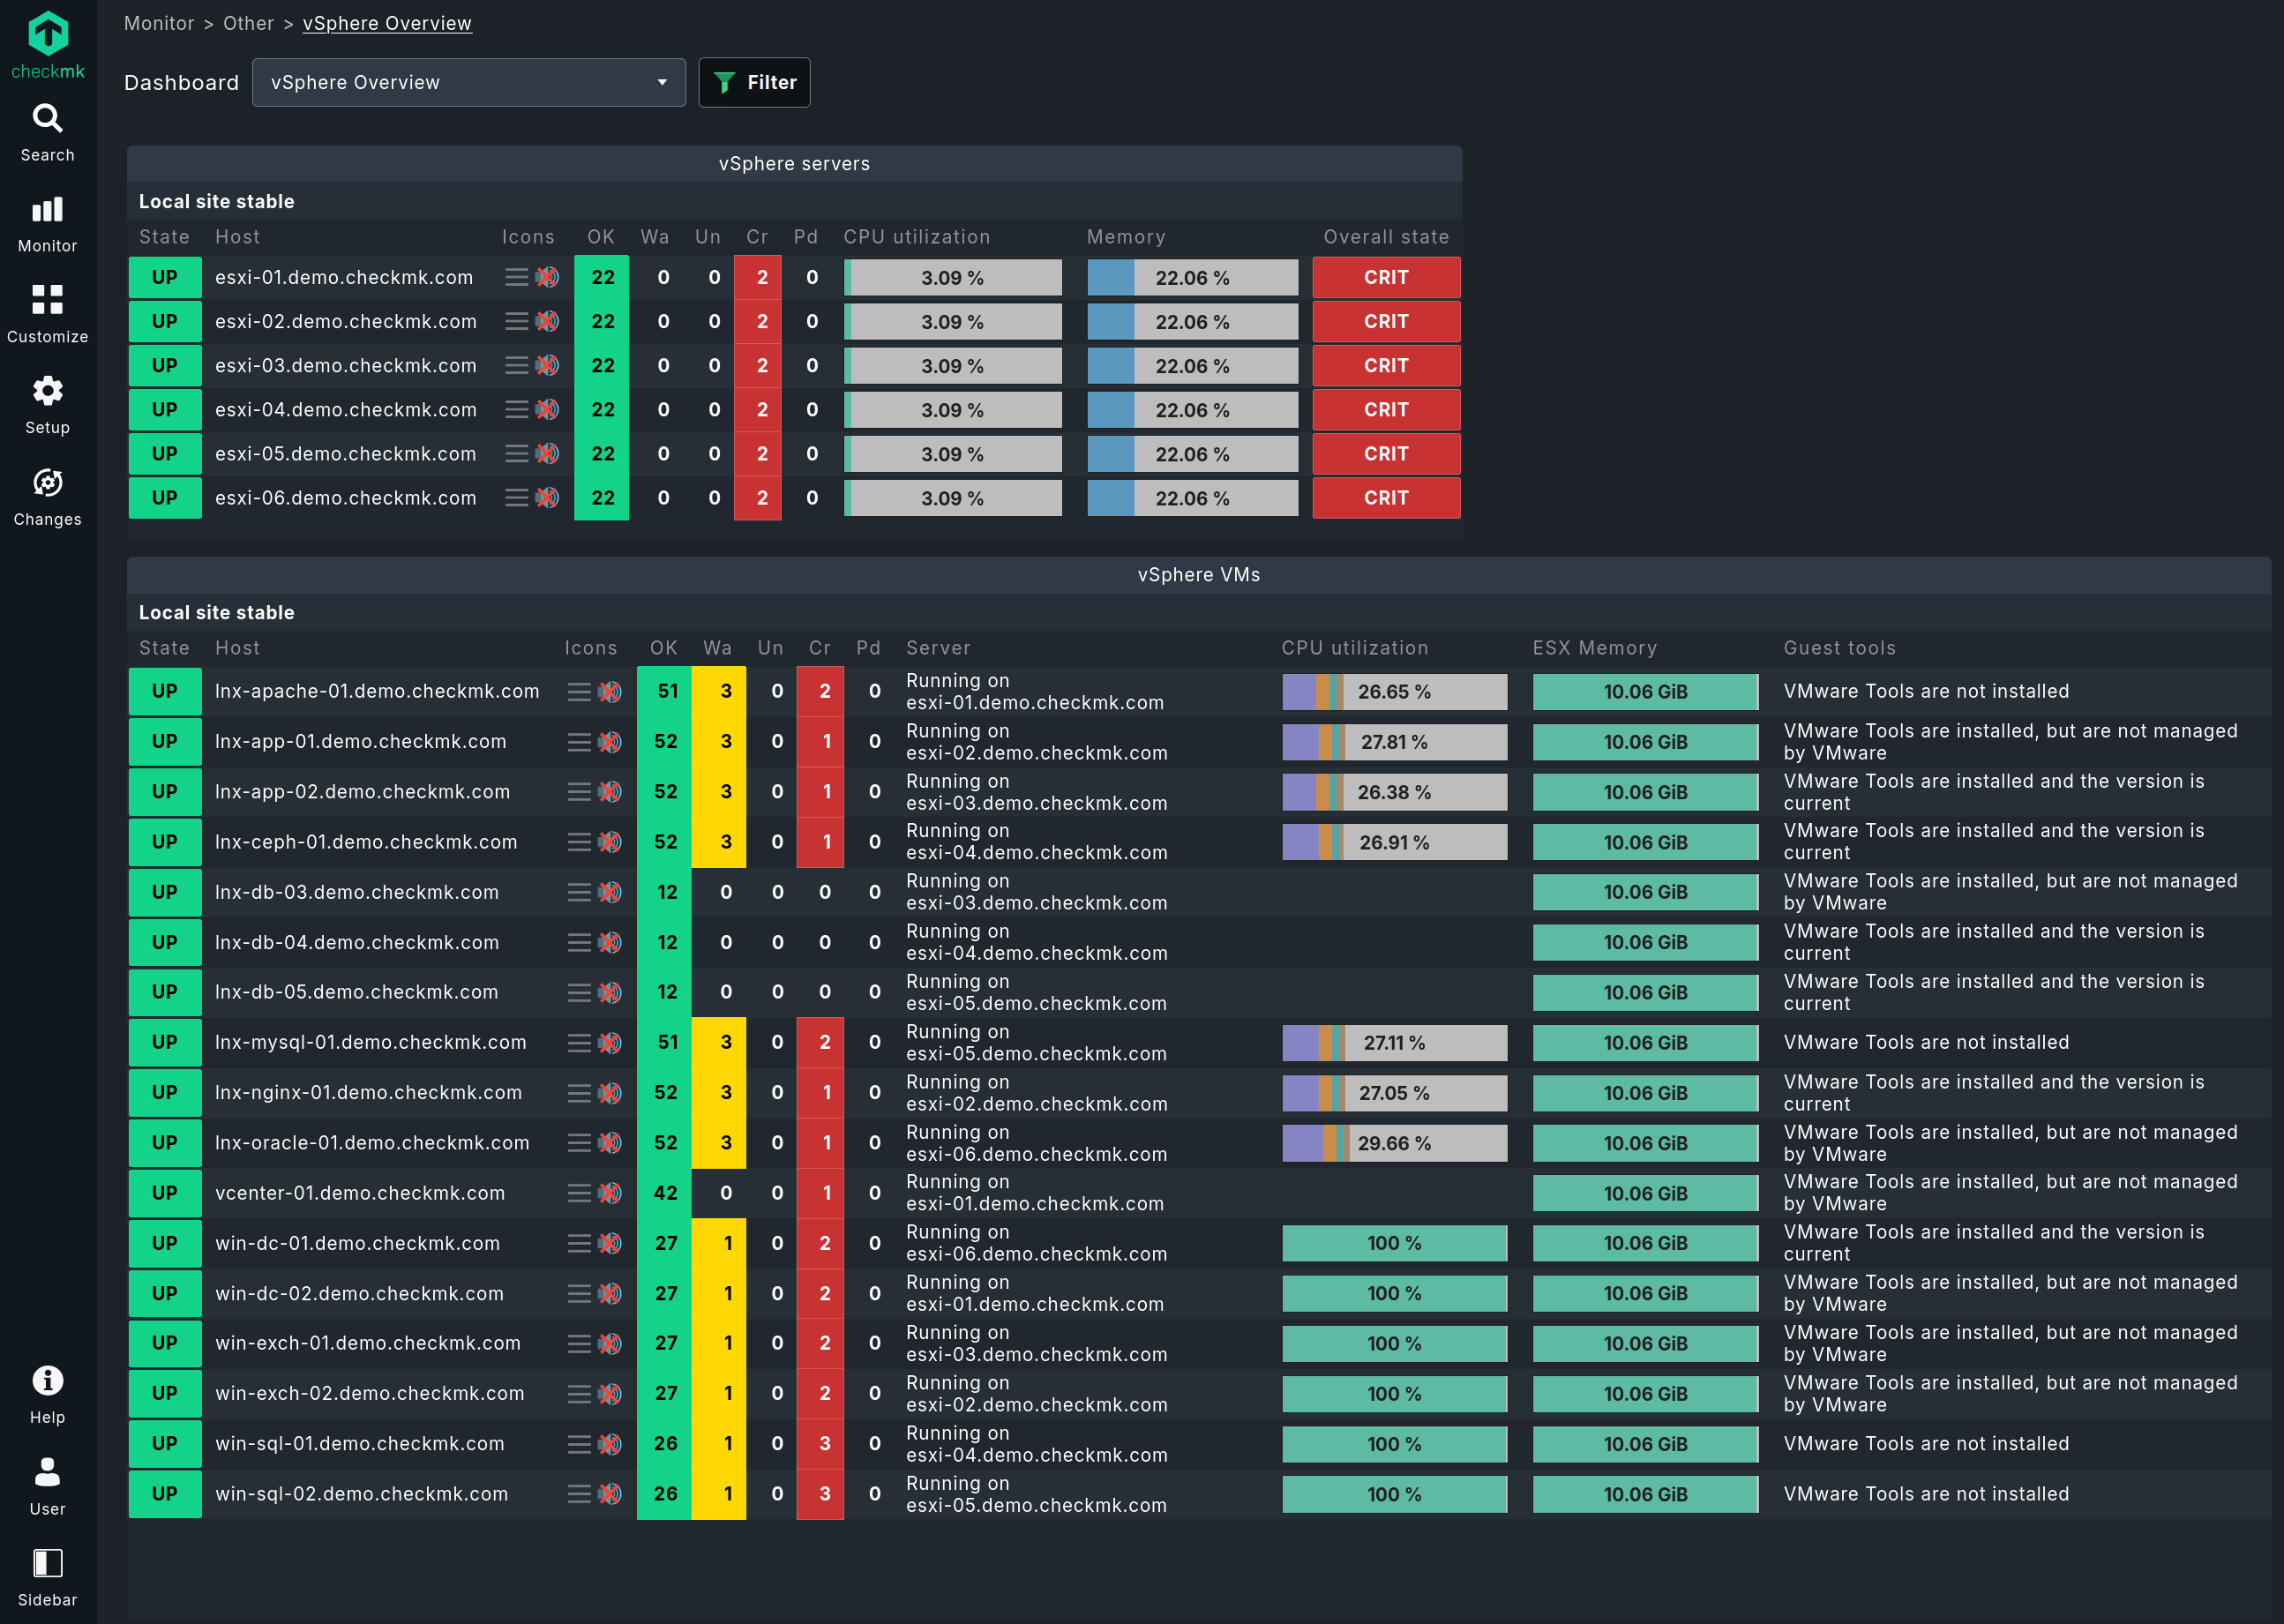
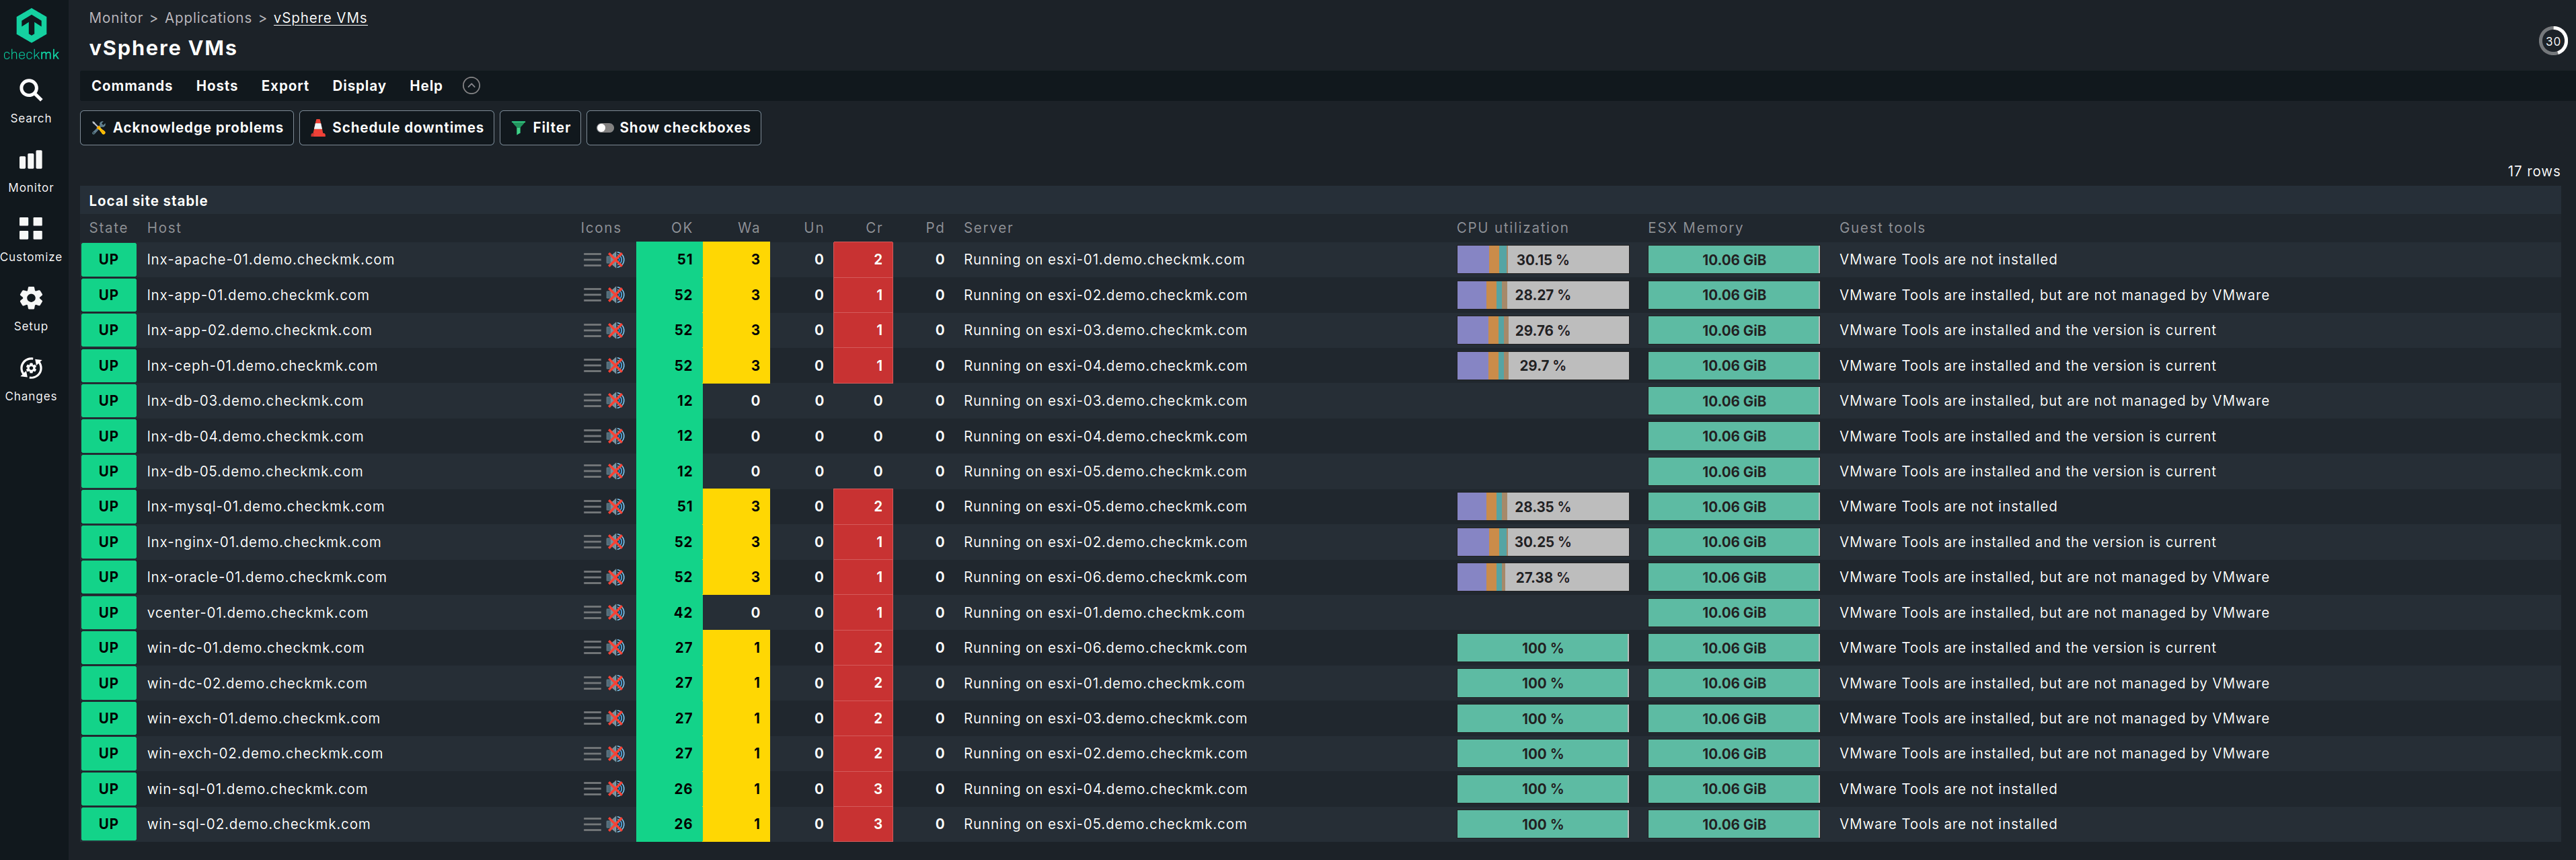
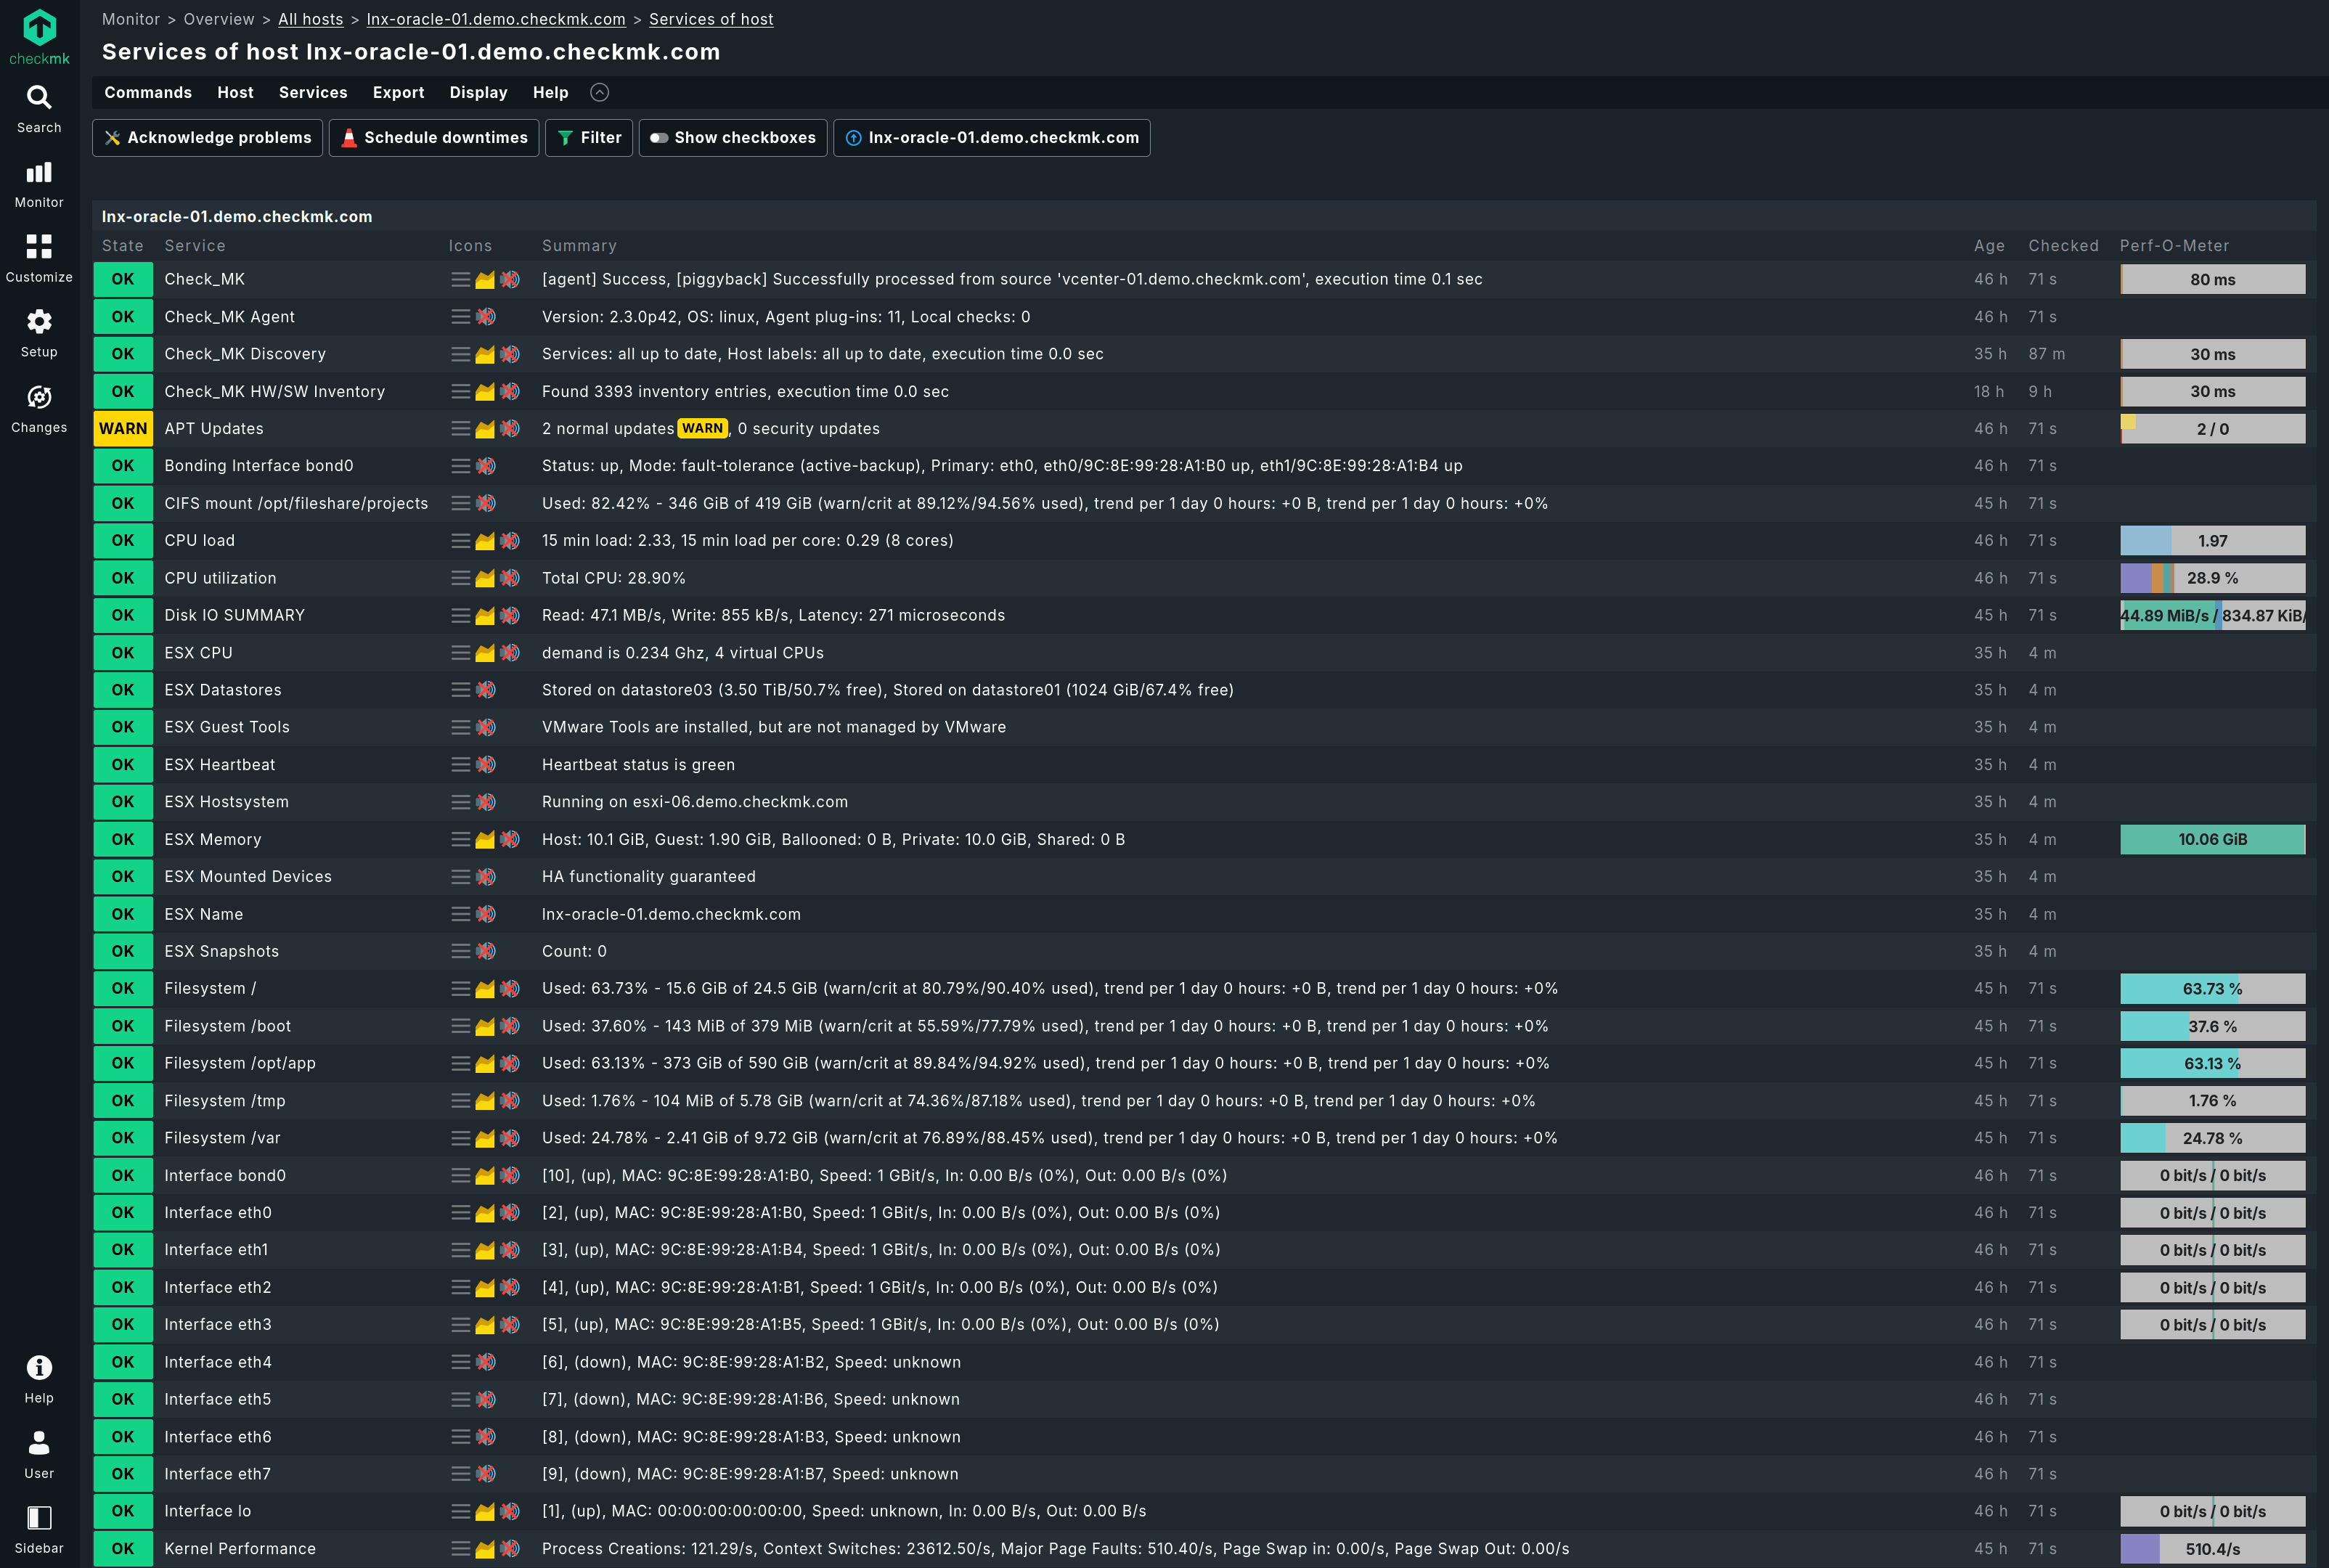
I dati possono provenire da API, agenti, SNMP, plug-in, integrazioni e fonti basate su hypervisor. Checkmk, ad esempio, può combinare i dati della piattaforma provenienti dalle piattaforme di virtualizzazione con il monitoraggio delle VM basato su agenti. Il suo meccanismo di piggyback assegna i dati di virtualizzazione ai relativi host VM, consentendo ai dati raccolti da un hypervisor di apparire nel contesto delle macchine virtuali corrispondenti. È così che il monitoraggio dell'infrastruttura può collegare le prospettive a livello di piattaforma e a livello guest invece di trattarle come viste separate.
Contestualizzare piattaforma e infrastruttura
Gli strumenti nativi sono efficaci nel raccogliere metriche grezze, ma poiché non possono correlare i dati tra diverse piattaforme, possono creare punti ciechi nell'infrastruttura di monitoraggio.
Ad esempio, se un'applicazione rallenta, la VM stessa è solo una delle possibili cause del problema. L'origine potrebbe risiedere nel carico dell'host, nella latenza dello storage, in errori di rete, problemi DNS, processi di backup, pressione sulla memoria o nel comportamento dell'applicazione all'interno del sistema operativo guest. Una visione di monitoraggio più ampia aiuta i team a tracciare i sintomi attraverso i vari livelli e a restringere più rapidamente la causa probabile.
Monitoraggio di VMware, Proxmox e Hyper-V
Questa correlazione è particolarmente importante in ambienti misti. Proxmox, VMware vSphere/ESXi, Microsoft Hyper-V, piattaforme cloud e altri ambienti mostrano metriche diverse e utilizzano terminologie differenti. Un monitoraggio efficace deve mappare queste diverse fonti per fornire una visione costante negli ambienti virtualizzati, considerando sia lo strato virtuale sia l'infrastruttura sottostante.
Gli ambienti dinamici richiedono anche un monitoraggio dinamico. La gestione dinamica degli host negli strumenti di monitoraggio consente l'aggiunta e la rimozione automatica degli host in base alle informazioni di monitoraggio, migliorando la scalabilità e l'efficienza nella gestione degli ambienti virtuali. Questo è importante quando le macchine virtuali in esecuzione oggi potrebbero essere spostate, rinominate, clonate o rimosse domani.
Trasformare i dati di monitoraggio in decisioni operative
Una volta raccolti e collegati i dati, il monitoraggio diventa utile per le operazioni IT quotidiane.
Dashboard unificate possono mostrare l'utilizzo delle risorse, l'allocazione, l'utilizzo dello storage e il comportamento della rete in un unico posto. Il monitoraggio in tempo reale aiuta i team a reagire rapidamente, mentre i dati storici li aiutano a comprendere le tendenze. Questa combinazione supporta sia la risoluzione dei problemi che la pianificazione della capacità.
L'analisi predittiva negli strumenti di virtualizzazione può aiutare a prevedere le esigenze di capacità analizzando i dati storici e le tendenze di utilizzo, consentendo un'allocazione più intelligente di CPU, memoria e storage negli ambienti virtualizzati, riducendo al minimo i tempi di inattività ed evitando l'eccesso di provisioning (overprovisioning).
Il risultato non è solo una maggiore quantità di dati. È la capacità di prendere decisioni migliori: quali server virtuali necessitano di più risorse, quali VM sottoutilizzate possono essere ridimensionate, quali host sono vicini alla saturazione, quali sistemi di storage stanno diventando colli di bottiglia e quali avvisi richiedono un intervento immediato.
Perché scegliere una soluzione di monitoraggio della virtualizzazione completa?
Una soluzione di monitoraggio completa offre diversi vantaggi rispetto agli strumenti nativi. In modo schematico e sintetico, le principali differenze per area di monitoraggio sono:
| Livello | Cosa vedono gli strumenti nativi della piattaforma | Cosa aggiunge il monitoraggio completo |
|---|---|---|
| Hypervisor & Host | Fornisce visibilità all'interno della propria piattaforma; gestisce le VM; monitora il carico dell'host, la pianificazione della CPU e l'allocazione delle risorse. | Correla i dati della piattaforma con le metriche del sistema operativo guest/infrastruttura; fornisce analisi predittive per la pianificazione della capacità e la gestione automatica dell'host. |
| Sistema Operativo Guest | Generalmente fornisce poca o nessuna visibilità sullo stato interno della macchina virtuale. | Monitora lo stato di salute dei processi, l'utilizzo del file system, lo stato dei servizi, i log e i dati di rete interni per una visione completa dell'applicazione. |
| Storage | Monitora lo storage dalla prospettiva della piattaforma (ad es. datastore). | Correla le prestazioni dello storage con i carichi di lavoro delle VM per identificare colli di bottiglia come latenza e problemi di IOPS che influiscono su più VM. |
| Rete | Monitora il traffico di rete a livello di piattaforma o di switch virtuale. | Mappa i percorsi di rete completi; traccia il traffico tra reti, perdita di pacchetti e latenza; correla gli errori di rete con le prestazioni di VM e host. |
Il punto più importante da considerare qui è la correlazione. Le metriche dell'hypervisor e quelle del sistema operativo guest raccontano spesso storie diverse. Un elevato CPU ready time indica un grave sovraccarico dell'host in un ambiente virtualizzato, anche se il sistema operativo guest non mostra un semplice problema di saturazione della CPU. Il Memory Ballooning, ovvero il recupero automatico della memoria inutilizzata da parte dell'hypervisor, segnala una carenza critica di memoria. Un'elevata latenza nello storage indica colli di bottiglia che possono influire sulle prestazioni delle applicazioni, anche quando le macchine virtuali corrispondenti sono ancora accese.
Il monitoraggio traccia l'utilizzo di CPU, memoria e storage per prevenire l'eccessiva allocazione delle risorse e risolvere l'effetto "noisy neighbor" (vicino rumoroso) negli ambienti virtuali. Quando una VM consuma troppe risorse, il monitoraggio rileva questo comportamento e consente agli amministratori di limitarne l'uso prima che influisca sulle applicazioni vicine.
Invece di costringere gli amministratori a ispezionare diverse dashboard scollegate, un monitoraggio completo offre ai team IT informazioni dettagliate in tempo reale e raccomandazioni pratiche nell'intera infrastruttura virtualizzata.
Impatto nel mondo reale del monitoraggio completo della virtualizzazione
Un esempio pratico è il monitoraggio di Proxmox con Checkmk 2.5. Checkmk include controlli integrati per Proxmox che portano più dati specifici sulla virtualizzazione nello stesso flusso di lavoro di monitoraggio del resto dell'infrastruttura. Questi controlli includono il monitoraggio del traffico di rete in entrata/uscita da VM e CT, il monitoraggio delle velocità di lettura/scrittura su disco di VM e CT, il monitoraggio dell'utilizzo della CPU delle VM, il monitoraggio dell'uptime delle VM, lo stato dei nodi e il monitoraggio della scadenza dell'abbonamento a Proxmox come parte delle informazioni sui nodi.
Questo tipo di dati aiuta a passare dal semplice monitoraggio delle VM a una comprensione operativa profonda. Invece di chiedersi solo: "Questa VM è accesa?", i team IT possono porsi queste domande:
- Quali macchine virtuali stanno consumando risorse di CPU, memoria, storage e rete?
- Le prestazioni della VM sono limitate dal sovraccarico dell'host, dalla latenza dello storage o dal comportamento del sistema operativo guest?
- Ci sono VM sottoutilizzate o macchine virtuali orfane che sprecano capacità
- Le risorse virtualizzate sono in overcommitment?
- Ci sono problemi di abbonamento, cluster o nodo che influenzano lo stato di salute operativo?
Senza un contesto completo, gli amministratori potrebbero dover ispezionare separatamente log dei guest, dashboard degli hypervisor, dispositivi di rete, sistemi di storage e strumenti di backup. Con un monitoraggio completo, i problemi di prestazioni possono essere tracciati attraverso tutti i livelli. Se una VM rileva scritture lente mentre l'hypervisor mostra latenza del datastore e i processi di backup sono attivi, il team ha un percorso molto più chiaro verso la causa radice.
È importante anche per il controllo dei costi. L'overprovisioning è comune negli ambienti virtuali perché sembra più sicuro allocare CPU, memoria e storage extra. Ma le risorse inutilizzate hanno comunque un costo. I dati storici consentono di identificare le macchine virtuali con un utilizzo delle risorse costantemente basso, recuperare capacità e ritardare l'acquisto superfluo di nuovo hardware.
La pianificazione della capacità diventa così più affidabile. Il monitoraggio della crescita dello storage, dell'utilizzo dei datastore, del CPU ready time, del memory ballooning e del throughput di rete aiuta i team a pianificare prima che i limiti diventino incidenti.
Il risultato è una minore gestione delle emergenze, meno punti ciechi e decisioni migliori nell'intera infrastruttura virtualizzata. E tutto questo con un unico strumento anziché destreggiarsi tra molteplici strumenti nativi.
Chi ha bisogno di un monitoraggio completo della virtualizzazione
I vantaggi sembrano chiari a questo punto, ma chi ha esattamente bisogno di un monitoraggio completo della virtualizzazione?
-
Team IT che gestiscono ambienti di virtualizzazione misti – Se la tua organizzazione utilizza Proxmox, VMware vSphere, Microsoft Hyper-V, piattaforme cloud o altre piattaforme di virtualizzazione, un unico livello di monitoraggio aiuta a ridurre la visibilità frammentata. Anche se ne vengono utilizzate solo un paio, un unico livello è molto più chiaro e rapido da comprendere.
-
Organizzazioni con problemi poco chiari sulle prestazioni delle VM – Se gli utenti segnalano applicazioni lente mentre la VM appare integra nella piattaforma nativa, il collo di bottiglia potrebbe risiedere nello storage, nella rete, nel carico dell'host, nei processi di backup o nel sistema operativo guest.
-
Aziende che necessitano di una migliore pianificazione della capacità – Se le decisioni di allocazione delle risorse si basano su snapshot attuali, i dati storici e l'analisi predittiva possono fornire una pianificazione più affidabile.
-
Team che cercano di ridurre i silos di strumenti – Un'unica console con flussi di lavoro di avviso coerenti aiuta le operazioni IT a evitare di passare da una dashboard all'altra durante gli incidenti.
-
Ambienti con requisiti di conformità o di operatività – Il monitoraggio fornisce la visibilità necessaria per prevenire i tempi di inattività, allocare le risorse in modo efficiente e proteggere i dati.
Tutti i punti sopra citati sono particolarmente importanti in ambienti in cui migrazioni dal vivo, variazioni delle richieste di risorse, finestre di backup e risorse virtualizzate in spostamento possono rendere inaccurate oggi le valutazioni di ieri.
Inoltre, un monitoraggio completo supporta anche la sicurezza e la conformità. Molti settori richiedono un rigoroso isolamento dei dati e gli strumenti di monitoraggio generano audit trail che ne dimostrano la conformità. Il tracciamento dei log dell'hypervisor per rilevare modifiche di configurazione o tentativi di accesso non autorizzati è uno sforzo fondamentale per identificare possibili rischi di sicurezza. Gli strumenti di monitoraggio possono anche rilevare un traffico di rete insolito o tentativi di accesso non autorizzati all'interno degli ambienti virtuali. Inoltre, evidenziare i sistemi operativi non aggiornati e le vulnerabilità dell'hypervisor è fondamentale per proteggere gli ambienti da problemi di sicurezza noti. Un ambiente virtualizzato introduce rischi di sicurezza unici che i tradizionali strumenti di sicurezza fisica in genere non sono progettati per rilevare.
Considerazioni sull'implementazione per il monitoraggio della virtualizzazione
Prima di aggiungere o espandere il monitoraggio della virtualizzazione, inizia dalle tue attuali lacune.
Raccogli sia le metriche dell'hypervisor sia quelle del sistema operativo guest? Riesci a vedere in un unico posto CPU ready time, memory ballooning, swap dell'host, latenza dei datastore, errori di rete e stati dei servizi a livello di guest? I tuoi strumenti di monitoraggio riescono a mappare le macchine virtuali sui server host, cluster, storage e percorsi di rete da cui dipendono?
Un sistema efficace di monitoraggio della virtualizzazione inizia con una visibilità completa. Deve colmare il divario tra i dati a livello di hypervisor e il sistema operativo all'interno di ciascuna macchina virtuale, integrandosi al contempo con il tuo specifico mix di piattaforme, che si tratti di Proxmox, VMware, Microsoft Hyper-V o ambienti cloud. Fondamentalmente, dovrebbe impiegare meccanismi come gli agenti piggyback per assegnare i dati a livello di host alle macchine virtuali corrette, garantendo una visione chiara delle prestazioni e delle dipendenze tra i vari livelli.
Gli ambienti virtuali sono altamente fluidi e richiedono un monitoraggio che si adatti al cambiamento costante. Il sistema deve supportare la discovery dinamica per rilevare e tracciare automaticamente le macchine virtuali man mano che vengono create, migrate, ridimensionate o rimosse. Ciò garantisce che la configurazione del monitoraggio rimanga accurata senza richiedere un intervento manuale ogni volta che l'infrastruttura cambia.
Oltre alla semplice raccolta dati, un monitoraggio efficace deve trasformare le metriche in informazioni pratiche e operative. Ciò richiede la definizione di logiche di avviso e soglie significative per le metriche di CPU, memoria, storage e rete. Inoltre, il sistema deve conservare dati storici sufficienti per facilitare l'analisi delle tendenze e l'analisi predittiva per la pianificazione della capacità, imponendo al contempo rigide riserve di storage per prevenire potenziali guasti dell'infrastruttura.
Infine, l'architettura di monitoraggio deve essere sia sicura sia scalabile. Dovrebbe tracciare attivamente i log dell'hypervisor, le modifiche di configurazione e i potenziali tentativi di accesso per mantenere la conformità e rilevare le vulnerabilità. Contemporaneamente, la piattaforma deve gestire il polling, la conservazione e la visualizzazione di grandi volumi di dati nell'intera infrastruttura senza introdurre un significativo overhead di prestazioni.
Valuta i tuoi punti ciechi
Verifica se il tuo monitoraggio copre macchine virtuali, hypervisor, sistemi operativi guest, storage, componenti di rete, server host e servizi in un unico flusso di lavoro. Cerca le lacune tra ciò che mostrano gli strumenti nativi della piattaforma e ciò di cui le operazioni IT hanno bisogno per mantenere le prestazioni.
Se vuoi esplorare come Checkmk supporta il monitoraggio della virtualizzazione, esamina le integrazioni di Checkmk disponibili e la panoramica del prodotto Checkmk. Per una guida alla configurazione specifica per piattaforma, consulta la documentazione di Checkmk per ambienti quali il monitoraggio di VMware, il monitoraggio di Proxmox, eseguire Hyper-V con l'appliance e altre integrazioni di virtualizzazione.
Gli strumenti di virtualizzazione nativi rimangono essenziali per la gestione delle piattaforme di virtualizzazione. Un monitoraggio completo aggiunge la visibilità più ampia necessaria per comprendere lo stato operativo dell'intera infrastruttura.
FAQ
Perché le metriche dell'hypervisor non sono sufficienti per il monitoraggio delle VM?
Le metriche dell'hypervisor sono necessarie, ma non mostrano tutto. Indicano ciò che vede la piattaforma di virtualizzazione: carico dell'host, allocazione delle risorse, CPU ready time, memory ballooning, latenza dello storage e throughput di rete. Non mostrano sempre cosa sta succedendo all'interno del sistema operativo guest, come problemi di processo, utilizzo del file system, errori applicativi, guasti ai servizi o pressione sulla memoria a livello guest.
Il monitoraggio delle macchine virtuali è più efficace quando i dati dell'hypervisor e quelli del sistema operativo guest vengono combinati. Gli strumenti nativi mostrano ciò che vede la piattaforma di virtualizzazione. Una piattaforma di monitoraggio dedicata può mostrare sia ciò che accade all'interno della VM che all'esterno.
Qual è la differenza tra il monitoraggio dell'hypervisor e quello guest?
Il monitoraggio dell'hypervisor si concentra sul livello dell'infrastruttura, tracciando lo stato di salute dell'host, la pianificazione della CPU, i percorsi di storage e l'allocazione delle risorse, per rivelare come l'ambiente virtuale supporti i carichi di lavoro. Il monitoraggio guest si concentra sul sistema operativo all'interno della macchina virtuale, tracciando metriche interne come lo stato dei processi, lo stato dei servizi e l'utilizzo della memoria, per rivelare ciò che l'applicazione sperimenta effettivamente.
Perché il monitoraggio delle VM è diverso dal monitoraggio della piattaforma di virtualizzazione?
La differenza tra il monitoraggio delle VM e il monitoraggio della piattaforma di virtualizzazione risiede nell'ambito e nella prospettiva dei dati raccolti. Il monitoraggio della piattaforma di virtualizzazione si concentra sull'hypervisor e sui server host, tracciando metriche come la pianificazione della CPU, l'utilizzo della memoria, la latenza dello storage, il throughput di rete e l'allocazione delle risorse a livello di piattaforma. Fornisce visibilità sullo stato operativo dell'infrastruttura virtuale dal punto di vista dell'hypervisor.
Al contrario, il monitoraggio delle VM guarda all'interno del sistema operativo guest di ogni macchina virtuale. Osserva l'utilizzo di CPU e memoria, i file system, i processi in esecuzione, i servizi, i log e il comportamento delle applicazioni all'interno della VM. Questo monitoraggio a livello guest rivela problemi che potrebbero non essere visibili a livello di hypervisor, come guasti ai servizi, errori delle applicazioni o pressione sulla memoria all'interno della VM.
Quali sono le best practice per il monitoraggio di VMware in ambienti di grandi dimensioni?
Per gli ambienti di grandi dimensioni, un monitoraggio efficace di VMware richiede un approccio completo e unificato. Le best practice principali consistono nella capacità di correlare i dati tra i vari livelli (come le metriche dell'hypervisor e le metriche interne di salute del sistema operativo guest), implementare funzioni di automazione e centralizzare le operazioni in un'unica piattaforma di monitoraggio per semplificare la gestione della grande quantità di dati in arrivo negli ambienti estesi.
Quali metriche sono importanti per il monitoraggio della virtualizzazione?
Il monitoraggio della virtualizzazione dipende da informazioni dettagliate sulla salute e sulle prestazioni dei sistemi virtuali che possono essere ottenute attraverso queste metriche chiave:
- Metriche dell'Hypervisor e dell'Host: includono CPU ready time, co-stop, utilizzo della memoria, memory ballooning, host swap, livelli di overcommitment, salute dei nodi e dei cluster e allocazione delle risorse virtuali.
- Metriche della Macchina Virtuale e del Sistema Operativo Guest: monitoraggio dell'utilizzo della CPU, del consumo di RAM, dell'I/O del disco, della salute del file system, dei processi in esecuzione, degli stati dei servizi, della swap guest, dei log e dei dati di rete all'interno del sistema operativo guest.
- Metriche di Storage: tracciamento dell'utilizzo dello storage, della latenza del datastore, degli IOPS del disco, del throughput in lettura/scrittura, della profondità della coda, dello stato degli snapshot, della salute della replica e dell'utilizzo della capacità.
- Metriche di Rete: misurazione del throughput, della perdita di pacchetti, della latenza, delle ritrasmissioni, del comportamento dello switch virtuale, della saturazione della NIC e del traffico tra le VM sullo stesso host fisico.
- Metriche di Sicurezza e Configurazione: osservazione dei log dell'hypervisor per modifiche di configurazione non autorizzate o tentativi di accesso, sistemi operativi non patchati e vulnerabilità dell'hypervisor.
Come posso rilevare problemi di capacità negli ambienti virtualizzati?
Gli indicatori chiave dei problemi di capacità negli ambienti virtualizzati includono il CPU ready time, il memory ballooning, la latenza del datastore e la saturazione della rete. Gli strumenti di monitoraggio che forniscono visibilità su queste metriche possono identificare gli host o i cluster che si avvicinano ai limiti di capacità prima che abbiano un impatto sulle prestazioni.
L'analisi predittiva migliora questo processo prevedendo le future richieste di risorse sulla base dei dati storici, consentendo ai team IT di scalare in modo efficiente e pianificare l'allocazione delle risorse in modo proattivo. Inoltre, il tracciamento delle macchine virtuali sottoutilizzate o sovradimensionate aiuta a ottimizzare l'uso delle risorse e a evitare investimenti hardware non necessari.
Le piattaforme di monitoraggio complete integrano i dati provenienti da hypervisor, sistemi operativi guest, storage e componenti di rete per offrire un'integrazione fluida delle informazioni. Questa visione unificata consente ai team di rilevare tempestivamente i colli di bottiglia, mantenere le massime prestazioni e migliorarle attraverso decisioni informate sulla gestione della capacità.
Perché i problemi di prestazioni delle VM derivano spesso da problemi di storage o di rete?
Le macchine virtuali dipendono fortemente dall'infrastruttura di storage e di rete sottostante, rendendo queste aree fonti comuni di problemi di prestazioni. La latenza dello storage, ad esempio, può creare colli di bottiglia che rallentano le operazioni di lettura/scrittura su disco, influenzando la reattività delle applicazioni all'interno della VM. La congestione della rete o la perdita di pacchetti possono degradare la comunicazione tra VM, host e servizi esterni, portando a timeout o a trasferimenti di dati lenti.
Inoltre, la condivisione delle risorse di storage e di rete significa che l'uso intensivo di una VM può avere un impatto sulle altre, un fenomeno noto come effetto "noisy neighbor" (vicino rumoroso). Gli strumenti di monitoraggio che tracciano l'utilizzo di CPU, memoria, storage e rete in tutti i livelli possono rilevare tempestivamente tali problemi e aiutare gli amministratori a limitare l'uso delle risorse per prevenire un degrado a cascata delle prestazioni.
I processi in background, come una routine di backup o altre attività di manutenzione, possono consumare sia lo storage che la larghezza di banda della rete, influenzando indirettamente le prestazioni delle VM. Correlando le metriche di storage e di rete con i dati dell'hypervisor e del sistema operativo guest, le piattaforme dedicate al monitoraggio della virtualizzazione forniscono il contesto operativo necessario per individuare e risolvere i problemi di prestazioni in modo efficace.
È necessario un monitoraggio aggiuntivo a vCenter o Proxmox?
Sì, se hai bisogno di visibilità operativa sull'intera infrastruttura IT. VMware vCenter, Proxmox VE e Hyper-V Manager sono strumenti di gestione essenziali per le rispettive piattaforme. Aiutano a configurare, utilizzare e ispezionare gli ambienti virtualizzati.
Ma il monitoraggio richiede una visione più ampia. Una piattaforma di monitoraggio dedicata come Checkmk integra gli strumenti nativi combinando i dati della piattaforma di virtualizzazione con il monitoraggio del sistema operativo guest, il monitoraggio dello storage, il monitoraggio della rete, gli avvisi, le dashboard, i grafici e i dati storici.
Quali soluzioni di monitoraggio forniscono supporto nativo sia per la virtualizzazione VMware che per quella Proxmox?
Checkmk è una soluzione di monitoraggio che fornisce supporto integrato sia per VMware (ESXi/vSphere) che per Proxmox, insieme ad altre piattaforme come Hyper-V e, non ufficialmente, Nutanix. Consente di monitorare centralmente questi ambienti eterogenei, correlando i dati a livello di piattaforma con le metriche a livello guest per fornire una visione unificata dell'infrastruttura.
Quali strumenti sono i migliori per il monitoraggio della virtualizzazione Proxmox e VMware?
Le soluzioni di monitoraggio complete come Checkmk sono ideali perché offrono un supporto nativo e integrato sia per Proxmox che per VMware (ESXi/vSphere), oltre a Hyper-V. Nutanix è supportato in pratica ma non ancora ufficialmente. Una soluzione di monitoraggio centralizzata è la migliore in quanto può facilmente correlare i dati a livello di piattaforma con le metriche a livello guest per offrire una visione unificata e coerente della salute dell'infrastruttura.
In che modo un monitoraggio completo può aiutare nella pianificazione della capacità?
La pianificazione della capacità dipende dalle tendenze, non dalle istantanee. Le dashboard native possono mostrare l'utilizzo attuale delle risorse, ma gli strumenti di pianificazione della capacità necessitano di dati storici su host, cluster, storage, rete e carichi di lavoro.
L'utilizzo delle tendenze storiche per prevedere le future esigenze di risorse può aiutare a prevenire l'over-provisioning negli ambienti virtuali. L'analisi predittiva negli strumenti di virtualizzazione può prevedere le esigenze di capacità e avvisare gli utenti di potenziali carenze di storage. Questo aiuta i team ad allocare CPU, memoria e storage in modo più intelligente, a identificare le VM sottoutilizzate e a evitare espansioni non necessarie.
Come posso monitorare centralmente Proxmox, vSphere e Hyper-V?
Una soluzione di monitoraggio completa raccoglie le metriche chiave da ogni hypervisor e dalle relative macchine virtuali, inclusi l'utilizzo di CPU, memoria, storage e rete. Integra inoltre il monitoraggio del sistema operativo guest per acquisire i dati a livello di sistema operativo e di applicazione all'interno di ogni VM. Correlando questi livelli, il sistema di monitoraggio è in grado di identificare colli di bottiglia nelle prestazioni che hanno origine all'esterno della VM, come la latenza dello storage o la congestione della rete.
Gli strumenti di monitoraggio nativi, come Proxmox VE, VMware vCenter e Hyper-V Manager, forniscono approfondimenti cruciali sui rispettivi ambienti, ma non offrono una visione consolidata tra le piattaforme o l'infrastruttura sottostante. Pertanto non sono in grado di monitorare tutti gli ambienti centralmente da un'unica piattaforma, ma necessitano di integrazione e personalizzazione, o di una soluzione di terze parti che faccia da ponte.
Le piattaforme di monitoraggio centralizzate supportano invece ambienti eterogenei normalizzando i dati provenienti da Proxmox, vSphere e Hyper-V in un'unica dashboard con avvisi e report coerenti. Ad esempio, Checkmk combina il monitoraggio di Proxmox, VMware e Hyper-V in un unico flusso di lavoro, utilizzando controlli integrati, monitoraggio delle VM basato su agenti e meccanismi di piggyback per associare correttamente i dati di host e guest.
Come posso monitorare Proxmox in modo più approfondito?
Il monitoraggio più approfondito di Proxmox richiede di andare oltre la sua interfaccia di gestione nativa per ottenere informazioni operative complete. Sebbene Proxmox VE fornisca metriche specifiche della piattaforma essenziali, come lo stato della VM, la salute del nodo e le prestazioni del cluster, non copre l'intero spettro delle dipendenze dell'infrastruttura e dei dettagli a livello di sistema operativo guest che influenzano le prestazioni della macchina virtuale.
Una soluzione di monitoraggio dedicata raccoglie dati dettagliati da più livelli: metriche dell'hypervisor come l'utilizzo della CPU, il memory ballooning e la latenza dello storage; metriche del sistema operativo guest, inclusi CPU, RAM, I/O del disco e servizi in esecuzione; nonché throughput di rete e tassi di errore. Questo approccio olistico aiuta a identificare i colli di bottiglia che potrebbero non essere visibili solo all'interno di Proxmox, come la contesa dello storage, la congestione della rete o gli host sovraccarichi.
Ad esempio, Checkmk 2.5 introduce controlli Proxmox integrati che monitorano il traffico di rete di VM e container, i tassi di lettura/scrittura del disco, l'utilizzo della CPU, l'uptime e lo stato dell'abbonamento. Questi controlli integrano i dati di Proxmox in un flusso di lavoro di monitoraggio unificato insieme ad altri componenti dell'infrastruttura. Ciò consente ai team IT di passare dal monitoraggio dello stato di base delle VM a intuizioni operative azionabili, come il rilevamento di risorse sovraccariche, l'individuazione di problemi di prestazioni causati dalla latenza dello storage e il tracciamento di VM sottoutilizzate o orfane.
In sintesi, un monitoraggio di Proxmox più profondo si ottiene combinando i dati nativi della piattaforma con le metriche del sistema operativo guest e dell'infrastruttura, fornendo una visione completa che supporta la risoluzione dei problemi, la pianificazione della capacità e la gestione proattiva oltre le capacità degli strumenti nativi di Proxmox.