Wo natives Virtualisierungs-Monitoring an seine Grenzen stößt
Virtualisierungs-Monitoring bedeutet mehr, als nur zu prüfen, ob virtuelle Maschinen (VMs) laufen. Es geht darum zu verstehen, wie VMs, Hypervisoren, Hosts, Storage, Netzwerke, Gastbetriebssysteme und Services in der gesamten Infrastruktur zusammenwirken.
Native Tools, die in Virtualisierungsplattformen integriert sind, sind unverzichtbar, um VMs und ihre Umgebungen zu verwalten. Meist bieten sie aber nur Einblick in die eigene Plattform. Das wird zum Problem, sobald Unternehmen zusätzliche Plattformen einsetzen, um Kosten zu senken oder bestimmte Workloads zu isolieren: Dann braucht es mehrere native Tools, die nicht miteinander kommunizieren. Zuverlässiges Performance-Monitoring für virtualisierte Umgebungen braucht eine übergreifende Ebene, die Plattformdaten mit Daten aus dem Gastbetriebssystem, Infrastruktur-Metriken, historischen Daten und handlungsrelevanten Alerts verbindet.
TL;DR:
- Native Plattform-Tools für VMware oder Proxmox sind unverzichtbar für die Verwaltung, bieten aber keine plattformübergreifende Sicht und keine tiefen Einblicke auf Gast-Ebene.
- Effektives Monitoring braucht einen einheitlichen Ansatz, der Plattform-Metriken, Daten aus dem Gastbetriebssystem, Storage und Netzwerk-Performance zueinander in Beziehung setzt.
- Ein umfassender, einheitlicher Blick reduziert Tool-Silos, ermöglicht vorausschauende Kapazitätsplanung und verbessert die operative Fehlersuche in der gesamten virtualisierten Infrastruktur spürbar.
Virtualisierung macht die Infrastruktur flexibler, fügt aber auch eine Abstraktionsebene hinzu
Virtuelle Maschinen lassen sich schnell erstellen, live migrieren, in der Größe anpassen, konsolidieren, sichern, klonen und entfernen. Gleichzeitig sind VMs auf gemeinsam genutzte CPU-, Arbeitsspeicher- und Storage-Ressourcen, Netzwerkpfade, Hypervisoren, Cluster und physische Hardware angewiesen. Virtuelle Maschinen lassen sich schnell erstellen, live migrieren, in der Größe anpassen, konsolidieren, sichern, klonen und entfernen. Gleichzeitig sind VMs auf gemeinsam genutzte CPU-, Arbeitsspeicher- und Storage-Ressourcen, Netzwerkpfade, Hypervisoren, Cluster und physische Hardware angewiesen.
Genau diese Flexibilität erschwert das Monitoring der virtuellen Infrastruktur. Eine VM kann im nativen Plattform-Dashboard unauffällig wirken, während Nutzer trotzdem Performance-Probleme melden. Die Ursache kann im Gastbetriebssystem liegen, auf dem Host, in der Storage-Schicht, in der Kommunikation zwischen VMs auf demselben physischen Host oder irgendwo im Netzwerkpfad außerhalb des Hypervisors.
Native Tools sind nicht dafür ausgelegt, einen einheitlichen operativen Überblick über das gesamte Rechenzentrum zu liefern. Deshalb muss Virtualisierungs-Monitoring die virtuelle Ebene mit der darunterliegenden physischen Infrastruktur verbinden – von Hypervisoren und Hosts über Storage und Netzwerke bis hin zu Gastbetriebssystemen.
Was effektives Virtualisierungs-Monitoring abdecken muss
Bessere Transparenz in virtualisierten Umgebungen erfordert nicht, Ihre bestehenden Tools zu ersetzen. Es geht darum, die richtigen Daten zu erfassen, Abhängigkeiten korrekt abzubilden und Performance-Metriken in Alerts, Grafiken und Trends zu übersetzen.
Daten aus mehreren Ebenen erfassen
Effektives Virtualisierungs-Monitoring braucht Transparenz über alle Ebenen, die sich auf Zustand und Performance der VMs auswirken, darunter:
- Hypervisoren und Host-Server – CPU Ready Time, Speicherauslastung, Memory Ballooning, Host-Swap, Overcommitment, Zustand der Knoten und Cluster-Zustand.
- VMs und Gastbetriebssysteme – CPU, RAM, Partitionen, Dateisysteme, Prozesse, Services, Guest-Swap, Logs und Netzwerkdaten auf Betriebssystemebene.
- Storage – Auslastung, Datastore-Latenz, Disk-IOPS, Lese-/Schreibdurchsatz, Snapshots, Replikation und Kapazitätsauslastung.
- Netzwerk – Durchsatz, Paketverlust, Latenz, Retransmissions, Verhalten des virtuellen Switches, NIC-Auslastung und East-West-Traffic zwischen VMs auf demselben physischen Host.
Das zeigt, warum Monitoring nicht bei der VM selbst aufhören darf. Teams brauchen auch Transparenz über Hosts, Storage, Netzwerke und Plattform-Ebenen, die sich auf Zustand und Performance der VMs auswirken.
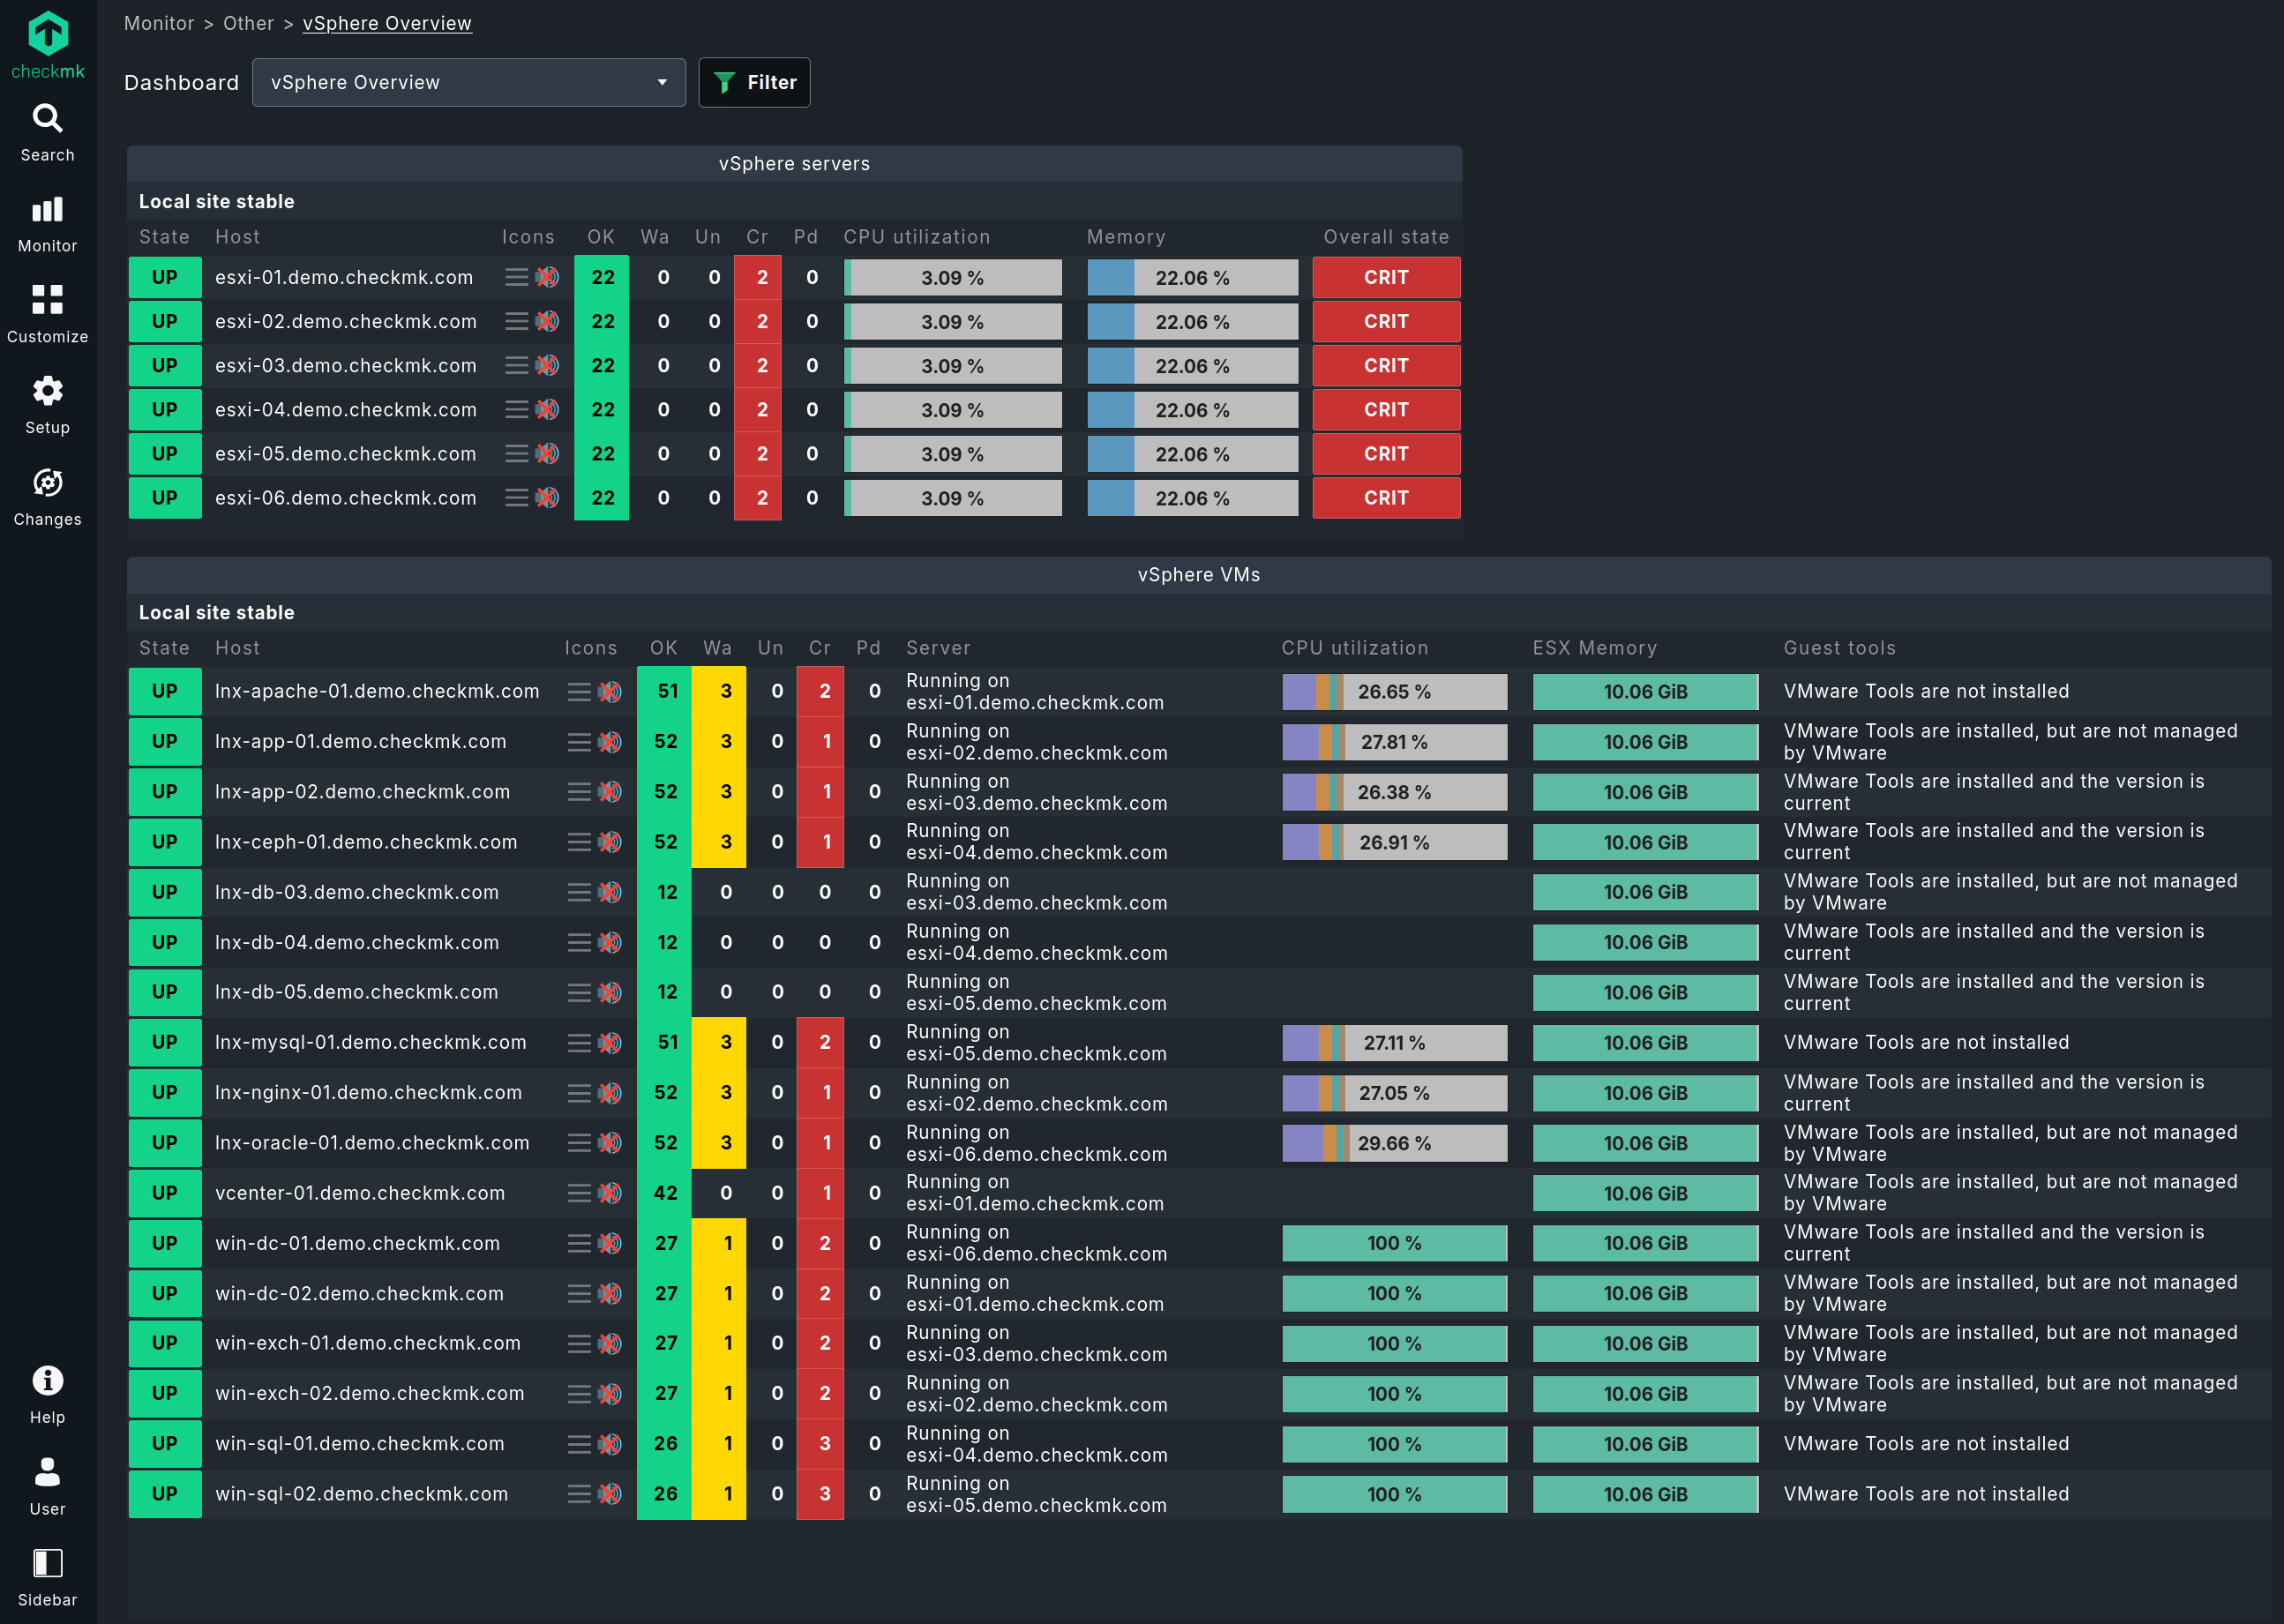
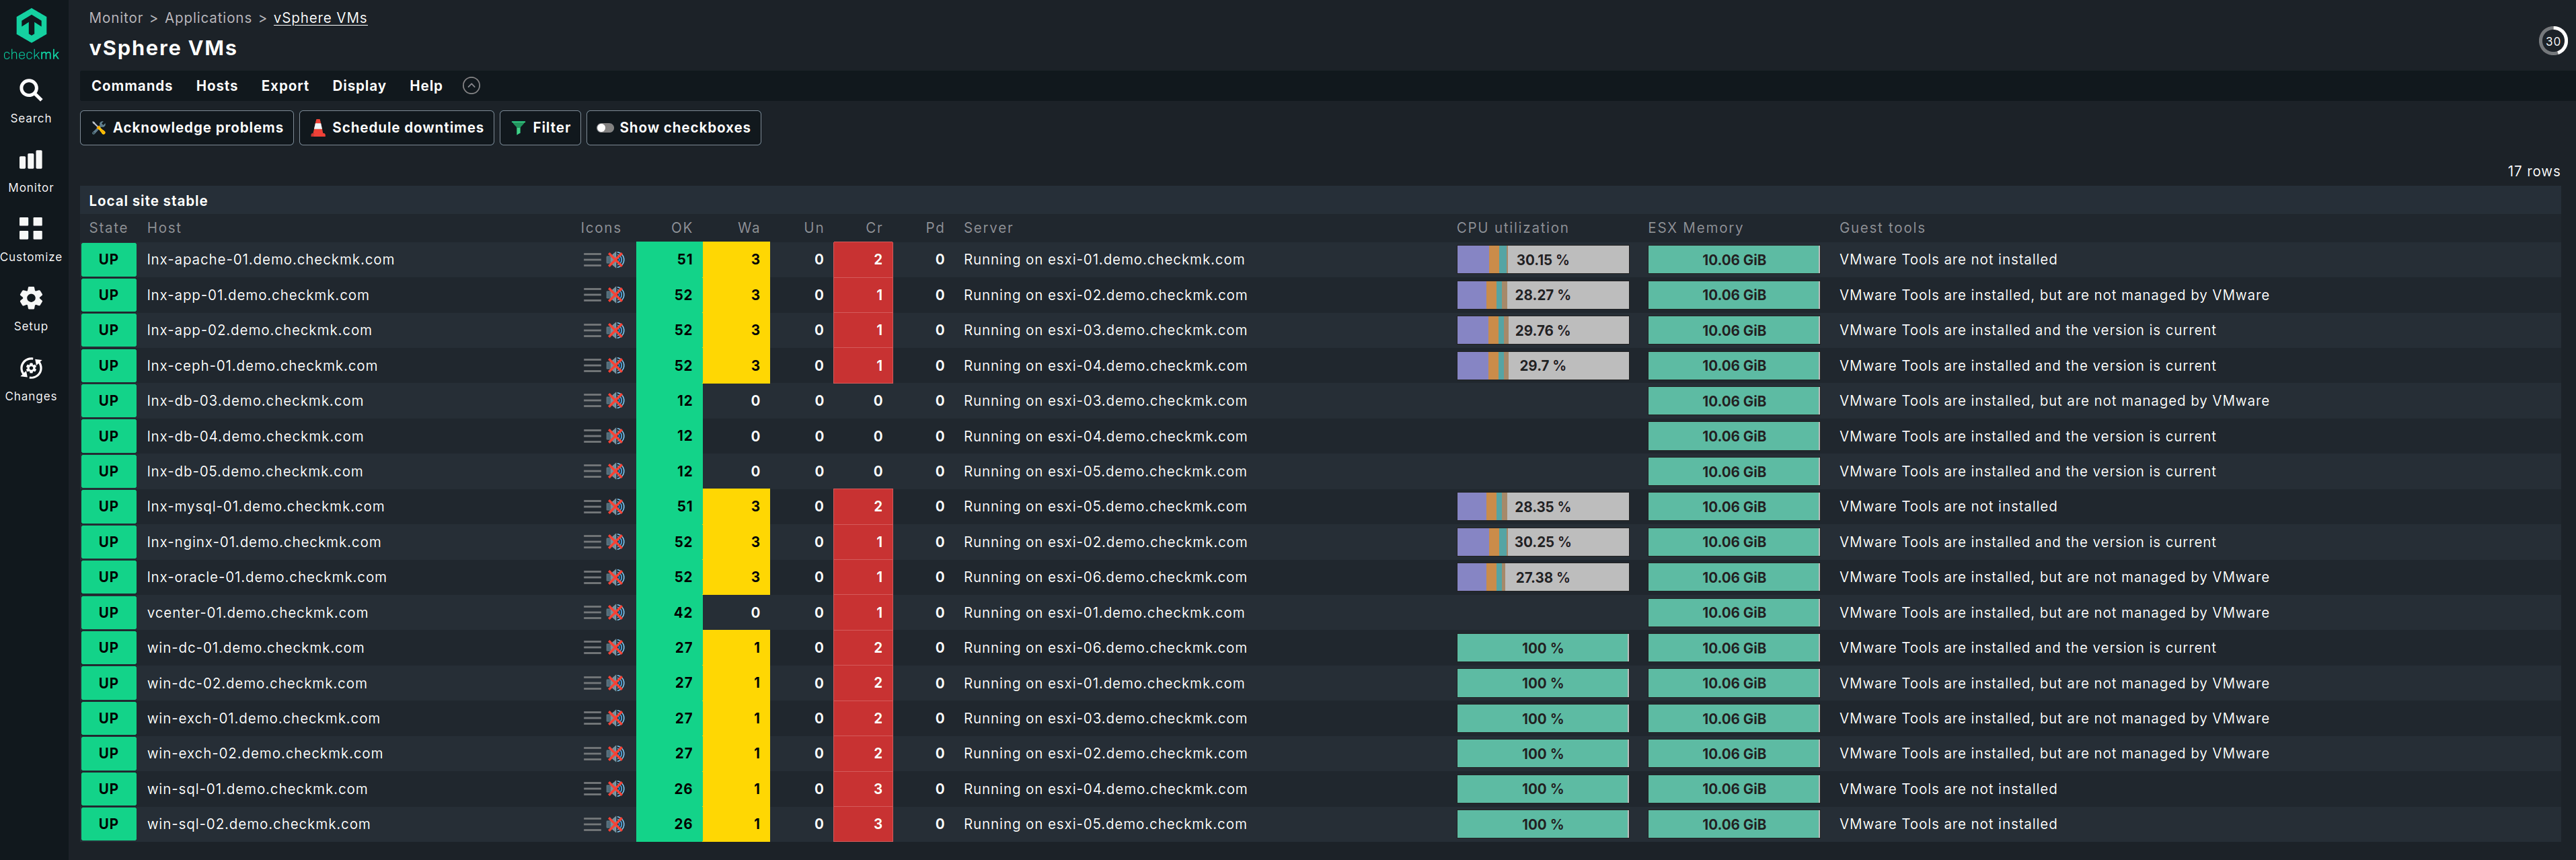
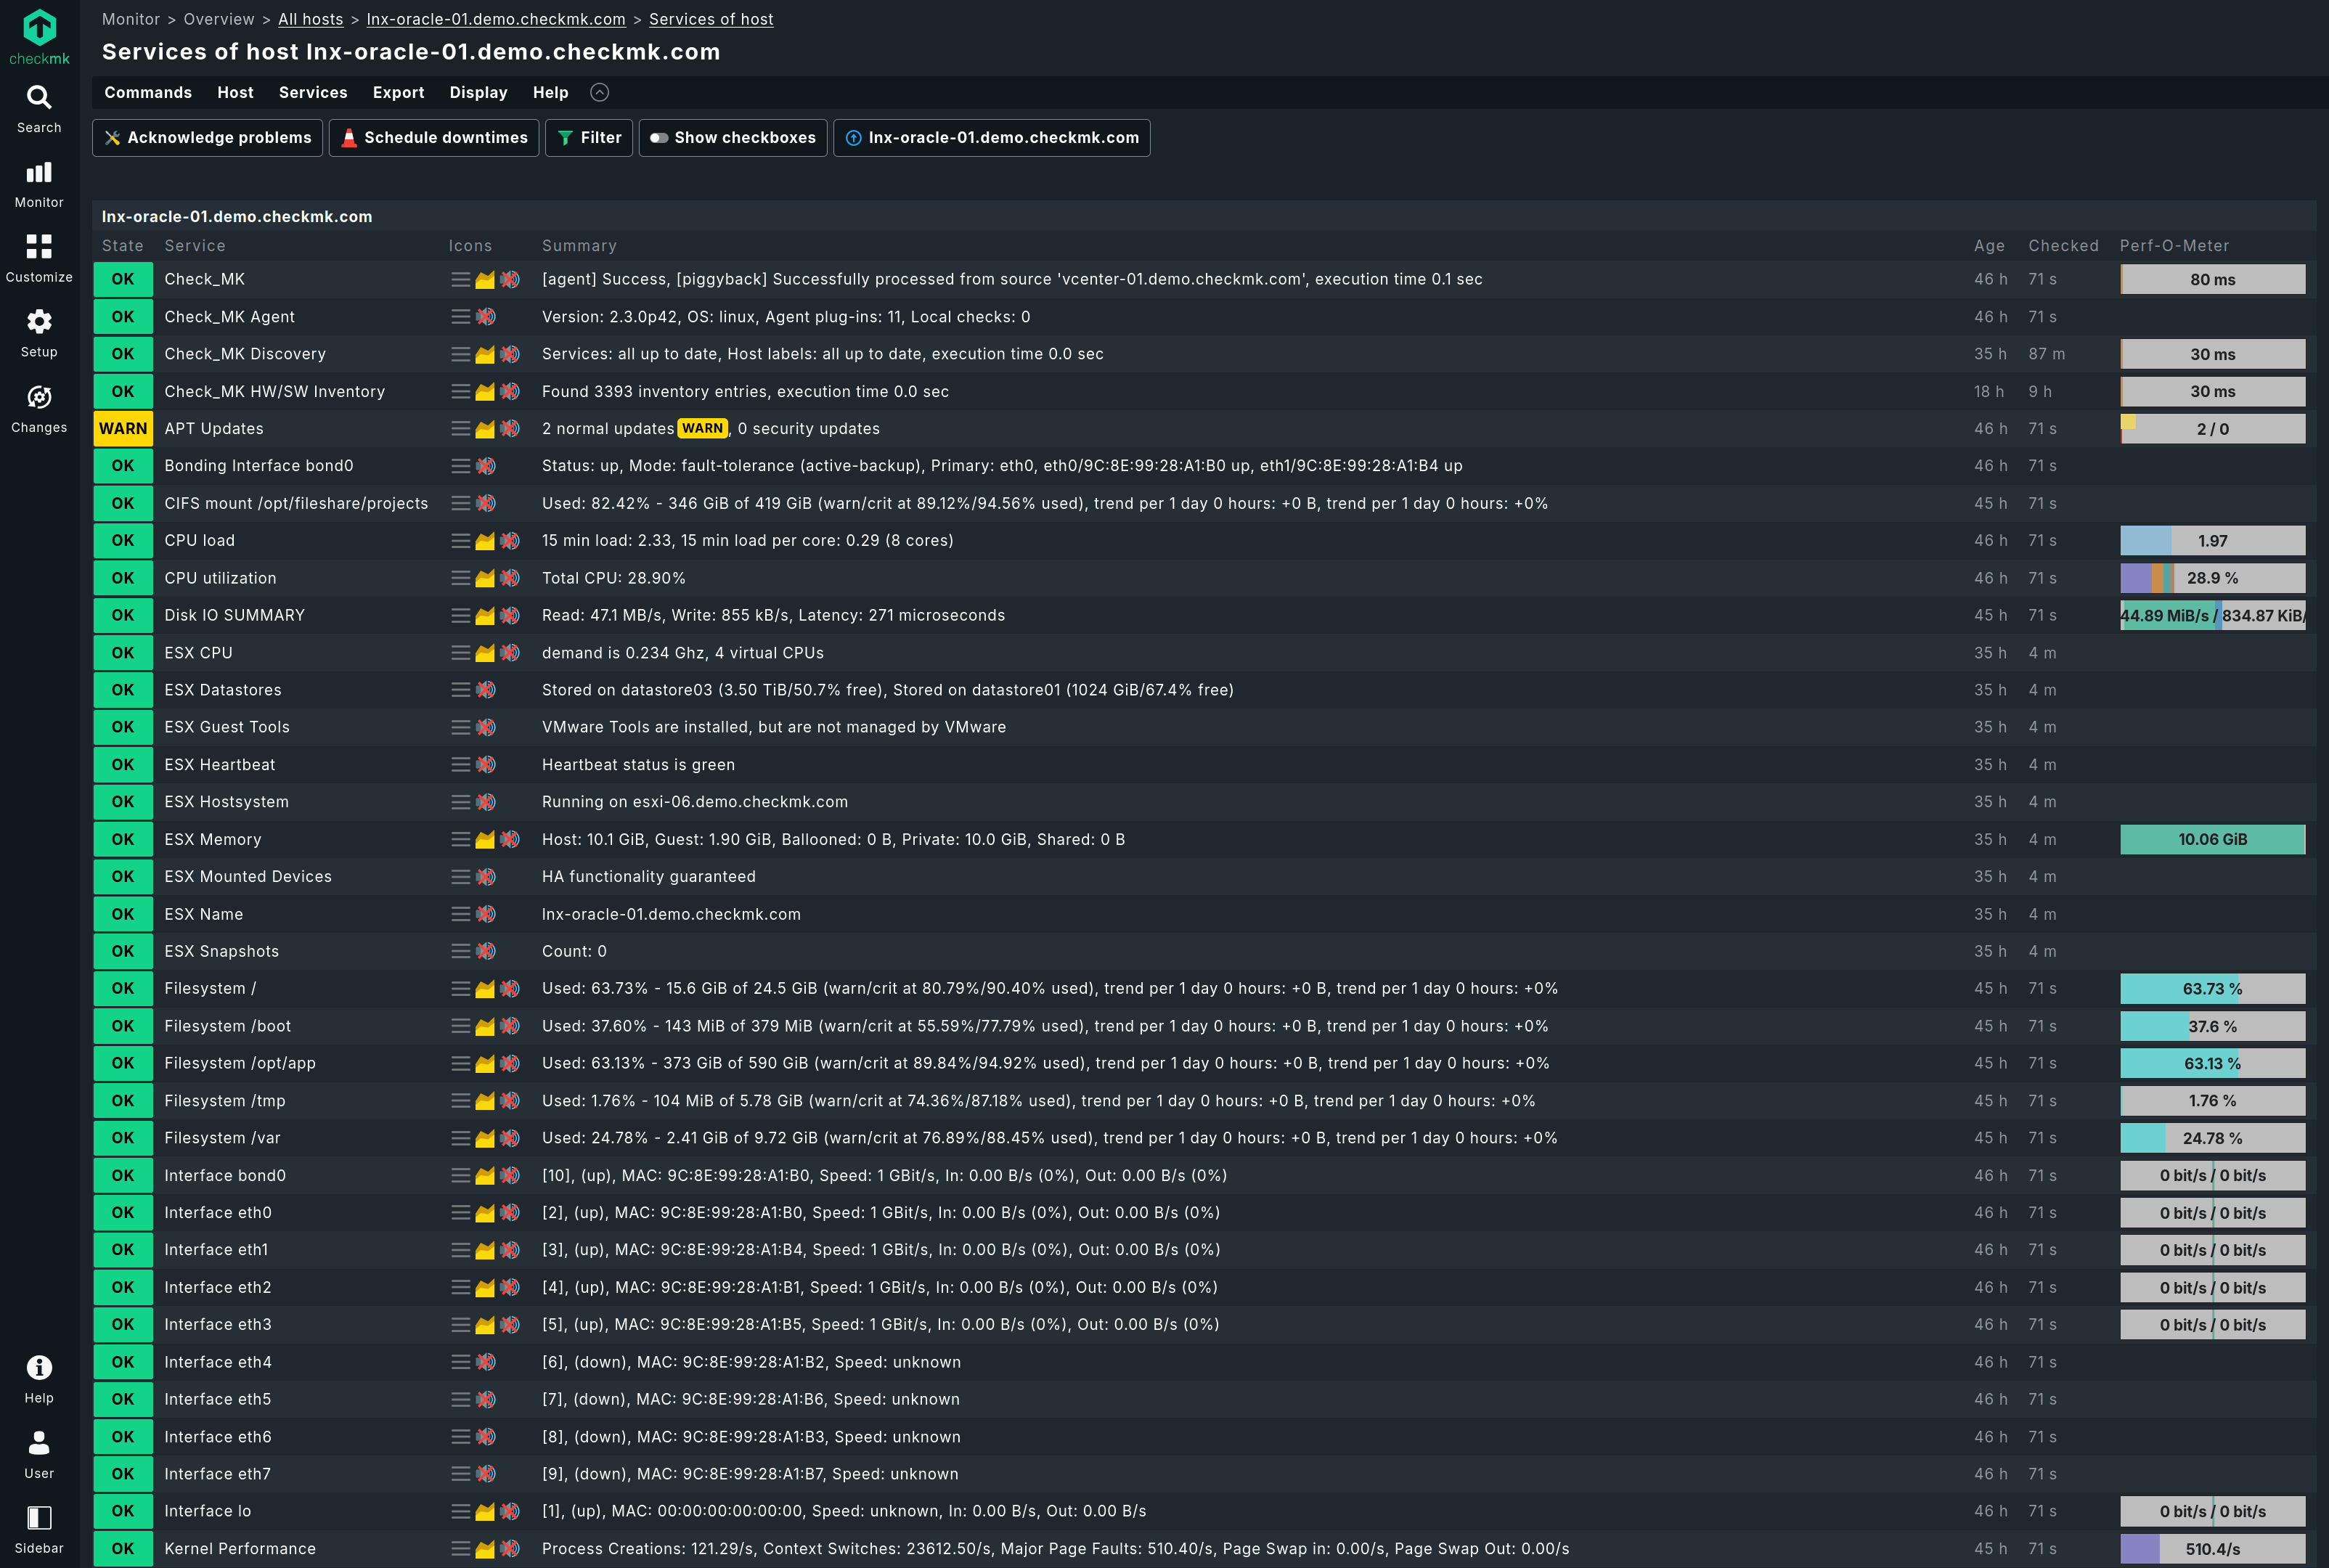
Diese Daten können aus APIs, Agents, SNMP, Plug-ins, Integrationen und hypervisor-basierten Quellen stammen. Checkmk kann beispielsweise Plattformdaten aus Virtualisierungsplattformen mit agentenbasiertem VM-Monitoring kombinieren. Der Piggyback-Mechanismus ordnet Virtualisierungsdaten den passenden VM-Hosts zu, sodass Daten, die am Hypervisor erfasst wurden, im Kontext der jeweiligen VM erscheinen. So verbindet Infrastruktur-Monitoring die Perspektive auf Plattform- und Gast-Ebene, statt sie getrennt zu betrachten.
Zusammenhänge zwischen Plattform und Infrastruktur erkennen
Native Tools sind gut darin, Rohmetriken zu erfassen. Weil sie Daten aber nicht über Ebenen und Plattformen hinweg zueinander in Beziehung setzen können, entstehen leicht blinde Flecken in Ihrer Monitoring-Infrastruktur.
Verlangsamt sich beispielsweise eine Anwendung, ist die VM selbst nur eine mögliche Ursache. Der Grund kann in der Host-Last, der Storage-Latenz, Netzwerkfehlern, DNS-Problemen, Backup-Prozessen, Speicherdruck oder im Verhalten der Anwendung innerhalb des Gastbetriebssystems liegen. Ein umfassenderer Blick aufs Monitoring hilft Teams, Symptome über mehrere Ebenen hinweg zu verfolgen und die wahrscheinliche Ursache schneller einzugrenzen.
Monitoring über VMware, Proxmox und Hyper-V hinweg
Dieser Zusammenhang ist besonders in gemischten Umgebungen wichtig. Proxmox, VMware vSphere/ESXi, Microsoft Hyper-V, Cloud-Plattformen und andere Umgebungen liefern unterschiedliche Metriken und verwenden unterschiedliche Terminologie. Effektives Monitoring muss diese unterschiedlichen Quellen zusammenführen, um einen durchgängigen Blick auf virtualisierte Umgebungen zu ermöglichen – sowohl auf die virtuelle Ebene als auch auf die darunterliegende Infrastruktur.
Dynamische Umgebungen brauchen auch dynamisches Monitoring. Eine dynamische Host-Verwaltung in Monitoring-Tools ermöglicht das automatische Hinzufügen und Entfernen von Hosts auf Basis von Monitoring-Daten und verbessert so Skalierbarkeit und Effizienz beim Verwalten virtueller Umgebungen. Das ist wichtig, denn eine VM, die heute läuft, kann morgen schon verschoben, umbenannt, geklont oder entfernt sein.
Monitoring-Daten in operative Entscheidungen verwandeln
Sobald Daten erfasst und miteinander verbunden sind, wird Monitoring auch für den IT-Alltag nützlich.
Einheitliche Dashboards zeigen Ressourcennutzung, Allokation, Storage-Auslastung und Netzwerkverhalten an einem Ort. Echtzeit-Monitoring hilft Teams, schnell zu reagieren, während historische Daten dabei helfen, Trends zu verstehen. Diese Kombination unterstützt sowohl die Fehlersuche als auch die Kapazitätsplanung.
Prognosebasierte Analysen in Virtualisierungstools helfen, den Kapazitätsbedarf zu prognostizieren, indem sie historische Daten und Nutzungstrends auswerten. Das ermöglicht eine intelligentere Verteilung von CPU, Arbeitsspeicher und Storage in virtualisierten Umgebungen, reduziert Ausfallzeiten und vermeidet Overprovisioning.
Das Ergebnis sind nicht einfach nur mehr Daten, sondern bessere Entscheidungen: welche virtuellen Server mehr Ressourcen brauchen, welche VMs sich verkleinern lassen, da sie kaum ausgelastet sind, welche Hosts an ihre Kapazitätsgrenze stoßen, welche Storage-Systeme zum Engpass werden, und welche Alerts sofortiges Handeln erfordern.
Warum eine umfassende Lösung fürs Virtualisierungs-Monitoring wählen?
Eine umfassende Monitoring-Lösung verbessert einige Bereiche gegenüber nativen Tools. Schematisch und kurz zusammengefasst sehen die wichtigsten Unterschiede je Monitoring-Bereich so aus:
| Ebene | Was native Plattform-Tools zeigen | Was umfassendes Monitoring zusätzlich bietet |
|---|---|---|
| Hypervisor & Host | Bietet Transparenz innerhalb der eigenen Plattform; verwaltet VMs; überwacht Host-Last, CPU-Scheduling und Ressourcenzuweisung. | Bringt Plattformdaten mit Metriken aus Gastbetriebssystem und Infrastruktur zusammen; liefert prognosebasierte Analysen für die Kapazitätsplanung und automatische Host-Verwaltung. |
| Gastbetriebssystem | Bietet in der Regel kaum bis keine Einblicke in den internen Zustand der VM. | Überwacht Zustand der Prozesse, Dateisystemnutzung, Service-Status, Logs und interne Netzwerkdaten für einen vollständigen Blick auf die Anwendung. |
| Storage | Überwacht Storage aus Sicht der Plattform (z. B. Datastores). | Bringt Storage-Performance mit VM-Workloads in Zusammenhang, um Engpässe wie Latenz- oder IOPS-Probleme zu erkennen, die mehrere VMs betreffen. |
| Netzwerk | Überwacht Netzwerk-Traffic auf Plattformebene oder am virtuellen Switch. | Bildet vollständige Netzwerkpfade ab; erfasst Traffic, Paketverlust und Latenz netzwerkübergreifend; bringt Netzwerkfehler mit VM- und Host-Performance in Zusammenhang. |
Der wichtigste Punkt dabei ist, Daten aus unterschiedlichen Ebenen zueinander in Beziehung zu setzen. Hypervisor-Metriken und Metriken aus dem Gastbetriebssystem erzählen oft unterschiedliche Geschichten. Eine hohe CPU Ready Time deutet auf eine starke Host-Überlastung in der virtualisierten Umgebung hin, selbst wenn das Gastbetriebssystem kein einfaches CPU-Sättigungsproblem zeigt. Memory Ballooning, also das automatische Zurückholen ungenutzten Speichers durch den Hypervisor, signalisiert einen kritischen Speicherengpass. Eine hohe Storage-Latenz deutet auf Engpässe hin, die die Anwendungsperformance beeinträchtigen können, selbst wenn die zugehörigen VMs noch eingeschaltet sind.
Monitoring erfasst CPU-, Speicher- und Storage-Nutzung, um eine Überallokation zu vermeiden und den „Noisy-Neighbor“-Effekt in virtuellen Umgebungen in den Griff zu bekommen. Verbraucht eine VM übermäßig viele Ressourcen, erkennt das Monitoring dieses Verhalten und ermöglicht es Administratoren, die Nutzung zu begrenzen, bevor benachbarte Anwendungen davon beeinträchtigt werden.
Statt mehrere unabhängige Dashboards einzeln zu prüfen, liefert umfassendes Monitoring IT-Teams Echtzeit-Einblicke, detaillierte Einblicke und handlungsrelevante Empfehlungen für die gesamte virtualisierte Infrastruktur.
Umfassendes Virtualisierungs-Monitoring in der Praxis
Ein praktisches Beispiel ist das Proxmox-Monitoring mit Checkmk 2.5. Checkmk bringt mit integrierten Proxmox-Checks mehr virtualisierungsspezifische Daten in denselben Monitoring-Workflow ein wie die restliche Infrastruktur. Dazu gehören die Überwachung von ein- und ausgehendem Netzwerk-Traffic von VMs und Containern (CTs), von Lese-/Schreibraten auf Disk-Ebene für VMs und CTs, der CPU-Nutzung von VMs, der VM-Laufzeit, des Knoten-Status sowie des Ablaufdatums des Proxmox-Abonnements als Teil der Knoteninformationen.
Diese Art von Daten hilft dabei, von einfachem VM-Monitoring zu operativem Mehrwert zu kommen. Statt sich nur zu fragen „Ist diese VM eingeschaltet?“, können IT-Teams jetzt fragen:
- Welche VMs verbrauchen CPU-, Speicher-, Storage- und Netzwerkressourcen?
- Wird die VM-Performance durch Host-Überlastung, Storage-Latenz oder das Verhalten des Gastbetriebssystems eingeschränkt?
- Gibt es kaum ausgelastete oder verwaiste VMs, die Kapazität verschwenden?
- Sind virtualisierte Ressourcen überbelegt (Overcommitment)?
- Beeinträchtigen Probleme mit Abonnements, Clustern oder Knoten den operativen Zustand?
Ohne den vollständigen Kontext müssen Administratoren häufig Guest-Logs, Hypervisor-Dashboards, Netzwerkgeräte, Storage-Systeme und Backup-Tools einzeln prüfen. Mit umfassendem Monitoring lassen sich Performance-Probleme über mehrere Ebenen hinweg nachverfolgen. Meldet eine VM langsame Schreibvorgänge, während der Hypervisor gleichzeitig Datastore-Latenz anzeigt und Backup-Jobs aktiv sind, hat das Team einen deutlich klareren Weg zur eigentlichen Ursache.
Das spielt auch für die Kostenkontrolle eine Rolle. Overprovisioning ist in virtuellen Umgebungen weit verbreitet, weil es sicherer erscheint, zusätzliche CPU-, Speicher- und Storage-Ressourcen einzuplanen. Ungenutzte Ressourcen kosten aber trotzdem Geld. Historische Daten machen es möglich, VMs mit dauerhaft niedriger Ressourcennutzung zu identifizieren, Kapazität zurückzugewinnen und unnötige Hardware-Anschaffungen hinauszuzögern.
Kapazitätsplanung wird dadurch zuverlässiger. Die Überwachung von Storage-Wachstum, Datastore-Nutzung, CPU Ready Time, Memory Ballooning und Netzwerkdurchsatz hilft Teams, zu planen, bevor aus erreichten Grenzwerten echte Vorfälle werden.
Das Ergebnis: weniger reaktives Krisenmanagement, weniger blinde Flecken und bessere Entscheidungen für die gesamte virtualisierte Infrastruktur – und das mit einem einzigen Tool, statt mit mehreren nativen Tools gleichzeitig jonglieren zu müssen.
Wer braucht umfassendes Virtualisierungs-Monitoring?
Die Vorteile liegen mittlerweile auf der Hand – aber wer braucht umfassendes Virtualisierungs-Monitoring konkret?
- IT-Teams mit gemischten Virtualisierungsumgebungen – Setzt Ihr Unternehmen Proxmox, VMware vSphere, Microsoft Hyper-V, Cloud-Plattformen oder andere Virtualisierungsplattformen ein, hilft eine einzelne Monitoring-Ebene dabei, fragmentierte Sichtbarkeit zu reduzieren. Selbst wenn nur zwei davon im Einsatz sind, ist eine einheitliche Ebene deutlich klarer und schneller zu erfassen.
- Organisationen mit unklaren VM-Performance-Problemen – Melden Nutzer langsame Anwendungen, während die VM in der nativen Plattform unauffällig wirkt, kann der Engpass in Storage, Netzwerk, Host-Last, Backup-Prozessen oder im Gastbetriebssystem liegen.
- Unternehmen, die eine bessere Kapazitätsplanung brauchen – Basieren Entscheidungen zur Ressourcenzuweisung bisher nur auf aktuellen Momentaufnahmen, sorgen historische Daten und prognosebasierte Analysen für eine zuverlässigere Planung.
- Teams, die Tool-Silos abbauen wollen – Eine einzige Konsole mit einheitlichen Alert-Workflows hilft IT-Teams, während Incidents nicht zwischen mehreren Dashboards wechseln zu müssen.
- Umgebungen mit Compliance- oder Verfügbarkeitsanforderungen – Monitoring liefert die Transparenz, die nötig ist, um Ausfälle zu verhindern, Ressourcen effizient zuzuweisen und Daten abzusichern.
All diese Punkte sind besonders wichtig in Umgebungen, in denen Live-Migrationen, wechselnder Ressourcenbedarf, Backup-Fenster und sich verändernde virtualisierte Ressourcen dazu führen, dass gestrige Annahmen heute schon nicht mehr stimmen.
Umfassendes Monitoring unterstützt außerdem Sicherheit und Compliance. Viele Branchen verlangen eine strikte Datenisolierung, und Monitoring-Tools erzeugen Audit Trails, die diese Compliance nachweisen. Die Auswertung von Hypervisor-Logs auf unautorisierte Konfigurationsänderungen oder Zugriffsversuche ist ein zentraler Baustein, um mögliche Sicherheitsrisiken zu erkennen. Monitoring-Tools können zudem ungewöhnlichen Netzwerk-Traffic oder unautorisierte Zugriffsversuche innerhalb virtueller Umgebungen aufdecken. Darüber hinaus ist es essenziell, ungepatchte Betriebssysteme und Schwachstellen im Hypervisor sichtbar zu machen, um Ihre Umgebungen vor bekannten Sicherheitsproblemen zu schützen. Eine virtualisierte Umgebung bringt eigene Sicherheitsrisiken mit sich, die klassische physische Sicherheitstools in der Regel nicht erkennen können.
Wichtige Überlegungen bei der Umsetzung von Virtualisierungs-Monitoring
Bevor Sie Virtualisierungs-Monitoring einführen oder ausbauen, sollten Sie zunächst Ihre aktuellen Lücken identifizieren.
Erfassen Sie sowohl Hypervisor- als auch Gastbetriebssystem-Metriken? Sehen Sie CPU Ready Time, Memory Ballooning, Host-Swap, Datastore-Latenz, Netzwerkfehler und Service-Status auf Guest-Ebene an einem Ort? Können Ihre Monitoring-Tools VMs den Host-Servern, Clustern, Storage- und Netzwerkpfaden zuordnen, von denen sie abhängen?
Ein effektives Virtualisierungs-Monitoring-System beginnt mit umfassender Transparenz. Es muss die Lücke zwischen Daten auf Hypervisor-Ebene und dem Betriebssystem innerhalb jeder VM schließen und sich gleichzeitig in Ihren jeweiligen Plattform-Mix integrieren – egal ob dieser Proxmox, VMware, Microsoft Hyper-V oder Cloud-Umgebungen umfasst. Entscheidend ist außerdem, dass es Mechanismen wie Piggyback-Agents nutzt, um Daten auf Host-Ebene den richtigen VMs zuzuordnen, damit Sie jederzeit einen klaren Blick auf Performance und Abhängigkeiten über alle Ebenen hinweg behalten.
Virtuelle Umgebungen sind extrem dynamisch, weshalb sich das Monitoring an diese ständige Bewegung anpassen muss. Das System muss dynamische Erkennung unterstützen, um VMs automatisch zu erkennen und zu verfolgen, sobald sie erstellt, migriert, in der Größe angepasst oder entfernt werden. So bleibt Ihre Monitoring-Konfiguration korrekt, ohne dass bei jeder Änderung Ihrer Infrastruktur manuell eingegriffen werden muss.
Über die reine Datenerfassung hinaus muss effektives Monitoring Metriken in handlungsrelevante Erkenntnisse übersetzen. Das erfordert sinnvolle Alert-Logik und Schwellwerte für CPU-, Speicher-, Storage- und Netzwerk-Metriken. Zusätzlich muss das System ausreichend historische Daten vorhalten, um Trendanalysen und prognosebasierte Analysen für die Kapazitätsplanung zu ermöglichen, und dabei strikte Storage-Reserven durchsetzen, um mögliche Infrastrukturausfälle zu vermeiden.
Schließlich muss die Monitoring-Architektur sowohl sicher als auch skalierbar sein. Sie sollte Hypervisor-Logs, Konfigurationsänderungen und mögliche Zugriffsversuche aktiv verfolgen, um Compliance sicherzustellen und Schwachstellen zu erkennen. Gleichzeitig muss die Plattform Polling, Retention und Visualisierung großer Datenmengen über Ihre gesamte Infrastruktur hinweg bewältigen, ohne spürbaren Performance-Overhead zu verursachen.
Nächste Schritte für besseres Virtualisierungs-Monitoring
Beginnen Sie damit, Ihre aktuellen blinden Flecken zu bewerten. Prüfen Sie, ob Ihr Monitoring VMs, Hypervisoren, Gastbetriebssysteme, Storage, Netzwerkkomponenten, Host-Server und Services in einem einzigen Workflow abdeckt. Achten Sie auf Lücken zwischen dem, was native Plattform-Tools zeigen, und dem, was der IT-Betrieb braucht, um die Performance aufrechtzuerhalten.
Wenn Sie erfahren möchten, wie Checkmk Virtualisierungs-Monitoring unterstützt, werfen Sie einen Blick auf die verfügbaren Checkmk-Integrationen und das Server-Monitoring von Checkmk. Für plattformspezifische Anleitungen zur Einrichtung nutzen Sie die Checkmk-Dokumentation für Umgebungen wie VMware-Monitoring, Proxmox-Monitoring, den Betrieb von Hyper-V über die Appliance und weitere Virtualisierungs-Integrationen.
Native Virtualisierungs-Tools bleiben unverzichtbar für die Verwaltung von Virtualisierungsplattformen. Umfassendes Monitoring ergänzt die notwendige, breitere Transparenz, um den operativen Zustand der gesamten Infrastruktur zu verstehen.
FAQ
Warum reichen Hypervisor-Metriken für VM-Monitoring nicht aus?
Hypervisor-Metriken sind notwendig, zeigen aber nicht alles. Sie zeigen, was die Virtualisierungsplattform sieht: Host-Last, Ressourcenzuweisung, CPU Ready Time, Memory Ballooning, Storage-Latenz und Netzwerkdurchsatz. Was innerhalb des Gastbetriebssystems passiert, zeigen sie dagegen nicht immer, etwa Prozessprobleme, Dateisystemnutzung, Anwendungsfehler, ausgefallene Services oder Speicherdruck auf Guest-Ebene.
VM-Monitoring ist am aussagekräftigsten, wenn Hypervisor-Daten und Daten aus dem Gastbetriebssystem kombiniert werden. Native Tools zeigen, was die Virtualisierungsplattform sieht. Eine dedizierte Monitoring-Plattform kann sowohl zeigen, was innerhalb der VM passiert, als auch, was drumherum geschieht.
Was ist der Unterschied zwischen Hypervisor- und Guest-Monitoring?
Hypervisor-Monitoring konzentriert sich auf die Infrastruktur-Ebene: Es erfasst Zustand des Hosts, CPU-Scheduling, Storage-Pfade und Ressourcenzuweisung, um zu zeigen, wie die virtuelle Umgebung Ihre Workloads unterstützt. Guest-Monitoring konzentriert sich auf das Betriebssystem innerhalb der VM und erfasst interne Metriken wie Prozesszustand, Service-Status und Speichernutzung, um zu zeigen, was die Anwendung tatsächlich erlebt.
Warum unterscheidet sich VM-Monitoring von Virtualisierungsplattform-Monitoring?
Der Unterschied zwischen VM-Monitoring und Virtualisierungsplattform-Monitoring liegt im Umfang und der Perspektive der erfassten Daten. Virtualisierungsplattform-Monitoring konzentriert sich auf Hypervisor und Host-Server und erfasst Metriken wie CPU-Scheduling, Speicherauslastung, Storage-Latenz, Netzwerkdurchsatz und Ressourcenzuweisung auf Plattformebene. Es liefert Transparenz über den operativen Zustand der virtuellen Infrastruktur aus Sicht des Hypervisors.
VM-Monitoring dagegen blickt in das Gastbetriebssystem jeder einzelnen VM hinein. Es beobachtet CPU- und Speichernutzung, Dateisysteme, laufende Prozesse, Services, Logs und das Verhalten von Anwendungen innerhalb der VM. Dieses Monitoring auf Guest-Ebene deckt Probleme auf, die auf Hypervisor-Ebene unter Umständen nicht sichtbar sind, etwa ausgefallene Services, Anwendungsfehler oder Speicherdruck innerhalb der VM.
Was sind VMware-Monitoring-Best-Practices für große Umgebungen?
Für große Umgebungen braucht effektives VMware-Monitoring einen umfassenden, einheitlichen Ansatz. Zu den wichtigsten Best Practices zählen die Fähigkeit, Daten über mehrere Ebenen hinweg zueinander in Beziehung zu setzen (etwa Hypervisor-Metriken und interne Metriken zum Zustand des Gastbetriebssystems), der Einsatz von Automatisierungsfunktionen sowie die Zentralisierung des Betriebs in einer einzigen Monitoring-Plattform, um die großen Datenmengen in umfangreichen Umgebungen effizient zu verarbeiten.
Welche Metriken sind für Virtualisierungs-Monitoring wichtig?
Virtualisierungs-Monitoring braucht detaillierte Informationen zum Zustand und zur Performance virtueller Systeme, die sich über folgende Kern-Metriken erfassen lassen:
- Hypervisor- und Host-Metriken: Dazu zählen CPU Ready Time, Co-Stop, Speicherauslastung, Memory Ballooning, Host-Swap, Overcommitment-Level, Zustand von Knoten und Cluster sowie die Zuweisung virtueller Ressourcen.
- VM- und Gastbetriebssystem-Metriken: Überwachung von CPU-Nutzung, RAM-Verbrauch, Disk-I/O, Zustand des Dateisystems, laufenden Prozessen, Service-Status, Guest-Swap, Logs und Netzwerkdaten innerhalb des Gastbetriebssystems.
- Storage-Metriken: Erfassung von Storage-Auslastung, Datastore-Latenz, Disk-IOPS, Lese-/Schreibdurchsatz, Queue Depth, Snapshot-Status, Zustand der Replikation und Kapazitätsauslastung.
- Netzwerk-Metriken: Messung von Durchsatz, Paketverlust, Latenz, Retransmissions, Verhalten des virtuellen Switches, NIC-Auslastung und Traffic zwischen VMs auf demselben physischen Host.
- Sicherheits- und Konfigurations-Metriken: Auswertung von Hypervisor-Logs auf unautorisierte Konfigurationsänderungen oder Zugriffsversuche, ungepatchte Betriebssysteme und Schwachstellen im Hypervisor.
Wie lassen sich Kapazitätsprobleme in virtualisierten Umgebungen erkennen?
Zu den wichtigsten Indikatoren für Kapazitätsprobleme in virtualisierten Umgebungen zählen CPU Ready Time, Memory Ballooning, Datastore-Latenz und Netzwerk-Sättigung. Monitoring-Tools, die Transparenz über diese Metriken liefern, können Hosts oder Cluster erkennen, die sich ihrer Kapazitätsgrenze nähern, bevor das die Performance beeinträchtigt.
Prognosebasierte Analysen verbessern diesen Prozess zusätzlich, indem sie künftigen Ressourcenbedarf auf Basis historischer Daten prognostizieren. So können IT-Teams effizient skalieren und die Ressourcenzuweisung vorausschauend planen. Zusätzlich hilft die Beobachtung von kaum ausgelasteten oder überprovisionierten VMs dabei, die Ressourcennutzung zu optimieren und unnötige Hardware-Investitionen zu vermeiden.
Umfassende Monitoring-Plattformen führen Daten aus Hypervisoren, Gastbetriebssystemen, Storage und Netzwerkkomponenten zu einem durchgängigen Gesamtbild zusammen. Dieser einheitliche Blick hilft Teams, Engpässe frühzeitig zu erkennen, die Performance konstant hochzuhalten und sie durch fundierte Entscheidungen im Kapazitätsmanagement weiter zu verbessern.
Warum liegen die Ursachen für VM-Performance-Probleme oft in Storage oder Netzwerk?
VMs sind stark von der zugrunde liegenden Storage- und Netzwerk-Infrastruktur abhängig, weshalb diese Bereiche häufige Ursachen für Performance-Probleme sind. Storage-Latenz kann beispielsweise Engpässe erzeugen, die Lese-/Schreibvorgänge auf der Disk verlangsamen und dadurch die Reaktionsfähigkeit von Anwendungen innerhalb der VM beeinträchtigen. Netzwerküberlastung oder Paketverlust können die Kommunikation zwischen VMs, Hosts und externen Services verschlechtern und zu Timeouts oder langsamen Datenübertragungen führen.
Da Storage- und Netzwerkressourcen gemeinsam genutzt werden, kann die intensive Nutzung durch eine VM zudem andere beeinträchtigen, ein Phänomen, das als „Noisy-Neighbor“-Effekt bekannt ist. Monitoring-Tools, die CPU-, Speicher-, Storage- und Netzwerkauslastung über alle Ebenen hinweg erfassen, können solche Probleme frühzeitig erkennen und Administratoren dabei helfen, die Ressourcennutzung zu begrenzen, bevor sich Performance-Probleme kaskadenartig ausbreiten.
Auch Hintergrundprozesse wie Backup-Routinen oder andere Wartungsaufgaben können sowohl Storage- als auch Netzwerkbandbreite beanspruchen und so die VM-Performance indirekt beeinträchtigen. Indem sie Storage- und Netzwerk-Metriken mit Hypervisor- und Gastbetriebssystem-Daten in Beziehung setzen, liefern dedizierte Virtualisierungs-Monitoring-Plattformen den operativen Kontext, der nötig ist, um Performance-Probleme gezielt zu identifizieren und zu lösen.
Brauche ich Monitoring zusätzlich zu vCenter oder Proxmox?
Ja, wenn Sie operative Transparenz über die gesamte IT-Infrastruktur hinweg brauchen. VMware vCenter, Proxmox VE und Hyper-V Manager sind unverzichtbare Verwaltungstools für ihre jeweils eigene Plattform. Sie helfen dabei, virtualisierte Umgebungen zu konfigurieren, zu betreiben und zu überprüfen.
Monitoring braucht aber einen breiteren Blick. Eine dedizierte Monitoring-Plattform wie Checkmk ergänzt native Tools, indem sie Daten aus der Virtualisierungsplattform mit Guest-OS-Monitoring, Storage-Monitoring, Netzwerk-Monitoring, Alerting, Dashboards, Grafiken und historischen Daten kombiniert.
Welche Monitoring-Lösungen bieten native Unterstützung für sowohl VMware als auch Proxmox?
Checkmk ist eine Monitoring-Lösung, die integrierte Unterstützung für sowohl VMware (ESXi/vSphere) als auch Proxmox bietet, dazu weitere Plattformen wie Hyper-V. Auch mit Nutanix funktioniert Checkmk in der Praxis, offizieller Support dafür steht allerdings noch aus. Damit lassen sich diese heterogenen Umgebungen zentral überwachen, Plattform-Daten und Metriken auf Guest-Ebene werden dabei zueinander in Beziehung gesetzt, um einen einheitlichen Blick auf die Infrastruktur zu liefern.
Welche Tools eignen sich am besten für Proxmox- und VMware-Virtualisierungs-Monitoring?
Umfassende Monitoring-Lösungen wie Checkmk eignen sich ideal, da sie integrierte Unterstützung für sowohl Proxmox als auch VMware (ESXi/vSphere) sowie für Hyper-V bieten. Auch mit Nutanix funktioniert Checkmk in der Praxis, offizieller Support dafür steht allerdings noch aus. Eine zentralisierte Monitoring-Lösung ist die beste Wahl, da sie Plattform-Daten und Metriken auf Guest-Ebene problemlos zueinander in Beziehung setzen kann, um einen einheitlichen, konsistenten Blick auf den Zustand Ihrer Infrastruktur zu liefern.
Wie unterstützt umfassendes Monitoring die Kapazitätsplanung?
Kapazitätsplanung basiert auf Trends, nicht auf Momentaufnahmen. Native Dashboards können die aktuelle Ressourcennutzung zeigen, aber für die Kapazitätsplanung braucht es historische Daten über Hosts, Cluster, Storage, Netzwerk und Workloads hinweg.
Trends auf Basis historischer Daten helfen dabei, künftigen Ressourcenbedarf vorherzusagen und so Overprovisioning in virtuellen Umgebungen zu vermeiden. Prognosebasierte Analysen in Virtualisierungstools können den Kapazitätsbedarf prognostizieren und Nutzer vor drohenden Storage-Engpässen warnen. Das hilft Teams dabei, CPU, Speicher und Storage intelligenter zuzuweisen, kaum ausgelastete VMs zu identifizieren und unnötige Erweiterungen zu vermeiden.
Wie lassen sich Proxmox, vSphere und Hyper-V zentral überwachen?
Eine umfassende Monitoring-Lösung erfasst zentrale Metriken aus jedem Hypervisor und dessen VMs, darunter CPU-, Speicher-, Storage- und Netzwerknutzung. Sie bindet außerdem Guest-OS-Monitoring ein, um Daten auf Betriebssystem- und Anwendungsebene innerhalb jeder VM zu erfassen. Indem diese Ebenen zueinander in Beziehung gesetzt werden, kann das Monitoring-System Performance-Engpässe erkennen, deren Ursache außerhalb der VM liegt, etwa Storage-Latenz oder Netzwerküberlastung.
Native Monitoring-Tools wie Proxmox VE, VMware vCenter und Hyper-V Manager liefern wichtige Einblicke in ihre jeweilige Umgebung, bieten aber keinen konsolidierten Blick über Plattformen oder die darunterliegende Infrastruktur hinweg. Sie können die Umgebungen also nicht zentral von einer einzigen Plattform aus überwachen, sondern erfordern Integration und Anpassung oder eine Drittanbieter-Lösung, die sie miteinander verbindet.
Zentralisierte Monitoring-Plattformen unterstützen heterogene Umgebungen dagegen, indem sie Daten aus Proxmox, vSphere und Hyper-V in einem einzigen Dashboard mit einheitlichem Alerting und Reporting zusammenführen. Checkmk bringt beispielsweise Proxmox-, VMware- und Hyper-V-Monitoring in einen einzigen Workflow, mithilfe integrierter Checks, agentenbasiertem VM-Monitoring und Piggyback-Mechanismen, um Daten korrekt zuzuordnen.
Wie kann ich Proxmox noch tiefer überwachen?
Um Proxmox tiefer zu überwachen, müssen Sie über die native Verwaltungsoberfläche hinausgehen, um umfassende operative Einblicke zu gewinnen. Proxmox VE liefert zwar wichtige plattformspezifische Metriken wie VM-Status, Knoten-Zustand und Cluster-Performance, deckt aber nicht das gesamte Spektrum an Infrastruktur-Abhängigkeiten und Guest-OS-Details ab, die die VM-Performance beeinflussen.
Eine dedizierte Monitoring-Lösung erfasst detaillierte Daten aus mehreren Ebenen: Hypervisor-Metriken wie CPU-Nutzung, Memory Ballooning und Storage-Latenz; Metriken aus dem Gastbetriebssystem wie CPU, RAM, Disk-I/O und laufende Services; sowie Netzwerkdurchsatz und Fehlerraten. Dieser ganzheitliche Ansatz hilft dabei, Engpässe zu erkennen, die innerhalb von Proxmox allein nicht sichtbar sind, etwa Storage-Konkurrenz, Netzwerküberlastung oder überlastete Hosts.
Checkmk 2.5 bringt beispielsweise integrierte Proxmox-Checks mit, die Netzwerk-Traffic von VMs und Containern, Lese-/Schreibraten auf Disk-Ebene, CPU-Nutzung, Laufzeit und Abonnement-Status überwachen. Diese Checks binden Proxmox-Daten in einen einheitlichen Monitoring-Workflow neben anderen Infrastrukturkomponenten ein. So können IT-Teams von einfachem VM-Status-Monitoring zu handlungsrelevanten operativen Erkenntnissen übergehen, etwa um überbelegte Ressourcen zu erkennen, durch Storage-Latenz verursachte Performance-Probleme gezielt zu identifizieren und kaum ausgelastete oder verwaiste VMs zu verfolgen.
Zusammengefasst: Tieferes Proxmox-Monitoring gelingt, indem native Plattformdaten mit Guest-OS- und Infrastruktur-Metriken kombiniert werden. So entsteht ein umfassender Blick, der Troubleshooting, Kapazitätsplanung und proaktives Management über die Möglichkeiten der nativen Proxmox-Tools hinaus unterstützt.